Iluzia eficienței automatizate
În mediul corporativ actual, promisiunea unui sistem de gestionare a conținutului (CMS) „inteligent” este adesea prezentată ca un remediu universal pentru supraîncărcarea informațională. Prin utilizarea AI pentru a automatiza indexarea, etichetarea și asocierea cuvintelor-cheie, organizațiile speră să elimine munca manuală de organizare a documentelor. Totuși, așa cum au descoperit mulți specialiști IT, delegarea structurării memoriei instituționale către un model AI necontrolat sau configurat necorespunzător poate transforma un depozit de informații vitale într-un cimitir digital în care datele pur și simplu se pierd.
Deficiența fundamentală rezidă adesea în dependența de regenerarea dinamică a etichetelor. Spre deosebire de indicii statici, creați de oameni, sistemele AI care reordonează dinamic conținutul în funcție de frecvența fluctuantă a cuvintelor sunt predispuse la interpretări eronate grave. Atunci când un algoritm nu poate face distincția între contexte diferite — de exemplu, confundarea dosarelor de tip „Manila” cu orașul Manila din Filipine — integritatea semantică a întregii baze de date începe să se prăbușească. Acest fapt creează un cerc vicios al dezinformării, în care rezultatele căutărilor devin tot mai irelevante, fiind îngropate sub straturi de metadate eronate.
Efectul de „gaură neagră”
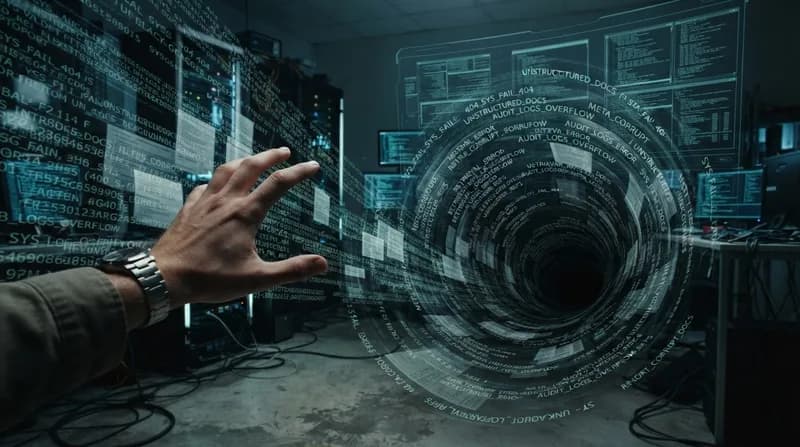
Poate cea mai insidioasă caracteristică a acestor sisteme este tendința de a păstra asocierile de metadate chiar și după ce documentele principale au fost șterse sau arhivate. Atunci când AI-ul încearcă să forțeze potrivirea unor cuvinte-cheie orfane cu fișiere fără legătură, rezultă un mediu labirintic în care cererile simple de căutare declanșează o avalanșă de documente învechite, înlocuite sau complet irelevante. Pentru angajați, acest lucru creează o situație în care găsirea unui document devine o chestiune de noroc pur, nu de căutare metodică.
Această volatilitate sistemică devine un instrument de evitare instituțională. În mediile în care CMS-ul funcționează ca o gaură neagră, încărcarea unui document servește drept bifă psihologică pentru finalizarea unei sarcini, indiferent dacă acel document va fi vreodată regăsit. Asigurându-se efectiv că nimeni nu poate găsi informația de care are nevoie, sistemul reduce, în mod ironic, cerințele de conformitate și revizuire, deoarece costul navigării prin haosul digital depășește valoarea resurselor în sine.
De ce contează acest lucru
- Pierderea cunoștințelor instituționale: Când versionarea documentelor devine o colecție haotică de „pre-drafturi” și fișiere „rectificate”, organizația își pierde capacitatea de a urmări istoricul propriilor decizii.
- Supra-corecția algoritmică: Sistemele dinamice de etichetare AI care se regenerează zilnic împiedică dezvoltarea unui index stabil, asigurând o inconsistență perpetuă a rezultatelor.
- Costul achizițiilor deficitare: Alegerea unor sisteme bazate pe funcționalități superficiale — cum ar fi profiluri cu avatare sau personalizarea culorilor etichetelor — în detrimentul unei gestionări fiabile a metadatelor duce la o paralizie operațională pe termen lung.
Implicații strategice
Dependența de asocierea „atotcuprinzătoare” a cuvintelor-cheie prin AI maschează adesea un eșec mai profund în arhitectura bazelor de date. Organizațiile care își tratează CMS-ul ca pe o groapă de gunoi pentru fișiere disparate, sperând că învățarea automată va impune ordine prin magie, se trezesc inevitabil captive într-un ciclu de recuperare a datelor pentru care puțini angajați au răbdarea sau timpul necesar. Pentru liderii din departamentele IT, lecția este clară: nicio sofisticare AI nu poate înlocui principiile de bază ale guvernanței datelor, un control riguros al versiunilor și o taxonomie gestionată de oameni.