Trecerea către AI în producție
Popularizarea modelelor de înaltă performanță pe Hugging Face Hub, precum generatorul de imagini fotorealiste DeepFloyd IF, a democratizat accesul la tehnologii AI de ultimă oră. Cu toate acestea, tranziția acestor modele consumatoare de resurse din mediul de cercetare către un serviciu scalabil, pregătit pentru producție, rămâne un obstacol major pentru mulți ingineri. BentoML oferă o soluție solidă, punând la dispoziție un framework standardizat și unitar pentru împachetarea, servirea și scalarea modelelor complexe de machine learning.
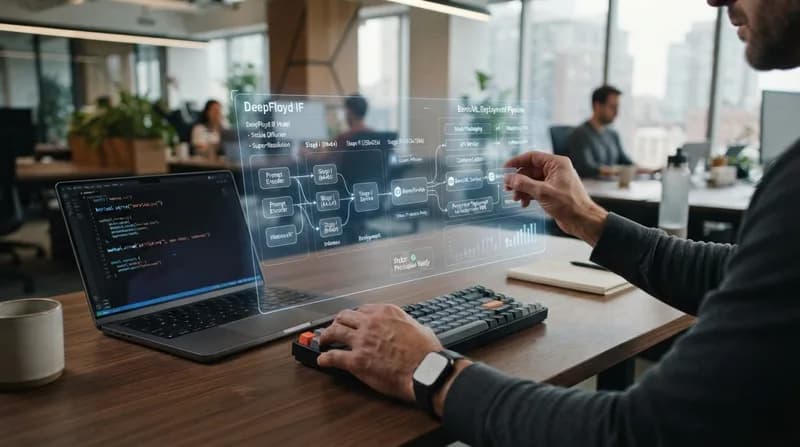
Spre deosebire de modelele tradiționale de difuzie latentă, DeepFloyd IF operează direct în spațiul pixelilor. Acesta utilizează o arhitectură modulară în trei etape, susținută de modelul de limbaj T5-XXL-1.1 pentru înțelegerea avansată a prompturilor. Deoarece modelul generează inițial imagini de 64x64 pixeli, pe care le scalează progresiv până la 1024x1024, este nevoie de un management precis al resurselor. BentoML excelează în acest punct, permițând dezvoltatorilor să gestioneze aceste etape ca „runner-e” independente, facilitând alocarea optimizată a GPU-ului pentru fiecare fază a fluxului de difuzie.
Workflow-ul BentoML explicat
Integrarea unui model în ecosistemul BentoML urmează un flux logic, structurat pentru implementări de tip cloud-native. Mai întâi, modelul este salvat în Model Store-ul local, care servește drept depozit centralizat pentru versionare și monitorizare. Ulterior, dezvoltatorul definește logica serviciului într-un script Python, creând „Runner-e” specializate care izolează sarcinile de inferență. Această separare este crucială pentru aplicațiile de înaltă performanță, deoarece permite scalarea independentă a resurselor de calcul.
După stabilirea logicii, pasul final constă în crearea unui „Bento” – un artefact imuabil care grupează modelul, codul și dependențele de mediu într-o singură unitate de implementare. Acest artefact poate fi apoi containerizat prin Docker și pus în funcțiune pe Kubernetes sau Yatai, asigurând o performanță constantă a modelului pe orice infrastructură cloud.
De ce contează
- Optimizarea resurselor: Rulând etapele de inferență pe pod-uri GPU separate, companiile pot evita costurile enorme generate de supra-alocarea resurselor.
- Paritatea cu producția: Împachetarea codului și a dependențelor într-un singur artefact Bento elimină problema clasică „pe mașina mea funcționează”, frecventă în dezvoltarea AI.
- Scalabilitatea: Utilizarea containerizării standard (Docker/Kubernetes) permite echipelor să scaleze serviciile AI dinamic, în funcție de trafic și de cererea de inferență.
Pregătirea pentru implementare și perspective
Pentru a implementa cu succes un model precum DeepFloyd IF, este recomandat, în general, un minim de 32GB până la 40GB VRAM pentru stabilitate în producție, deși maparea creativă a GPU-urilor poate permite rularea etapelor pe mai multe dispozitive cu specificații mai reduse. Prin utilizarea fișierelor de configurare BentoML furnizate, dezvoltatorii pot desemna GPU-uri specifice pentru diferite etape, îmbunătățind considerabil timpul de răspuns al interfeței web, care poate fi susținută de Gradio pentru teste rapide.
Pe măsură ce AI-ul generativ evoluează, capacitatea de a itera și implementa rapid modele, menținând în același timp un uptime ridicat, va deveni un diferențiator critic. Ecosistemul BentoML, care include suport pentru OpenLLM și diverse servicii bazate pe Transformer, oferă o cale scalabilă pentru organizațiile care doresc să depășească etapa de prototip și să livreze soluții AI la nivel enterprise.