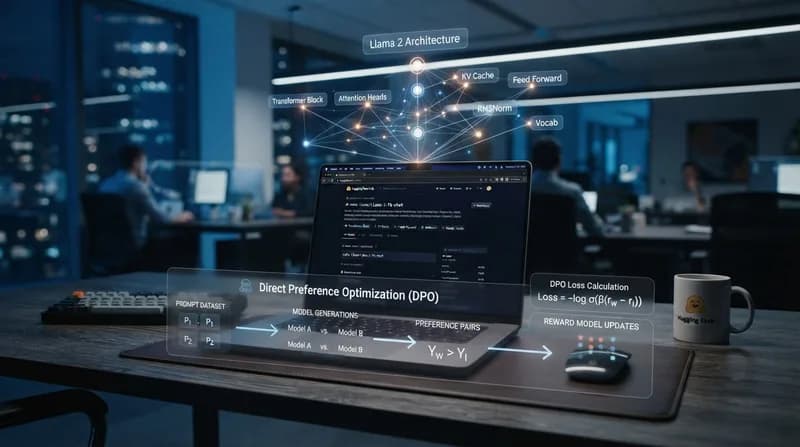
Revoluția în alinierea modelelor
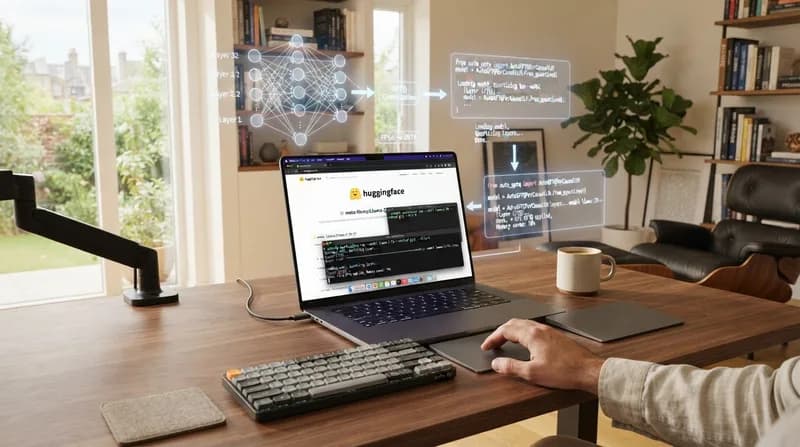
Dezvoltarea modelelor lingvistice de mari dimensiuni a ajuns într-un punct crucial odată cu implementarea tehnicii Direct Preference Optimization (DPO) pentru Llama 2. Până acum, alinierea modelelor conform preferințelor umane necesita structuri complexe de tip Reinforcement Learning from Human Feedback (RLHF), care implicau gestionarea mai multor modele simultan și a unui model de recompensă separat. Prin utilizarea DPO, dezvoltatorii pot acum să eficientizeze acest flux de lucru, eliminând nevoia unei infrastructuri externe costisitoare.
DPO funcționează prin optimizarea directă a modelului lingvistic pe baza datelor de preferință, cum ar fi seturile de date care disting între răspunsurile „alese” și cele „respinse”. Această metodă creează o legătură stabilă și eficientă din punct de vedere computațional între antrenarea de bază a modelului și generarea de rezultate aliniate la așteptările umane. Folosind biblioteca TRL (Transformer Reinforcement Learning) de la Hugging Face, cercetătorii pot integra aceste tehnici avansate de aliniere în fluxurile de lucru existente cu un efort minim.
De ce contează
- Eficiență: DPO elimină necesitatea antrenării unui model de recompensă separat, reducând considerabil consumul de memorie GPU.
- Simplitate: Simplifică ciclul de antrenare, permițând echipelor mai mici să atingă niveluri de performanță rezervate anterior marilor laboratoare de cercetare.
- Performanță: Fine-tuning-ul bazat pe date de preferință generează modele mai utile, care tind să producă mai puține erori sau conținut halucinat.
Perspective privind implementarea
Integrarea setului de date kashif/stack-llama-2 demonstrează modul în care datele colectate de comunitate pot fi utilizate pentru a rafina modelele de bază. Pe măsură ce comunitatea open-source adoptă DPO, ne așteptăm la o creștere rapidă a disponibilității unor variante Llama 2 optimizate pentru domenii specifice. Această schimbare marchează o tranziție mai amplă în dezvoltarea AI, unde accentul se mută de la simpla scalare a parametrilor către rafinarea comportamentului modelului prin metodologii de optimizare sofisticate și accesibile. Prin reducerea barierelor de intrare în ceea ce privește alinierea bazată pe RL, Hugging Face facilitează apariția unei noi generații de aplicații AI robuste și sigure, care reflectă tiparele reale de interacțiune umană, nu doar probabilitățile statistice. Dezvoltatorii care doresc să își rafineze propriile modele dispun acum de un model tehnic elegant și scalabil, ceea ce va asigura faptul că Llama 2 va rămâne o forță dominantă în ecosistemul open-source AI pentru perioada următoare.