Democratizarea eficienței modelelor prin Quanto
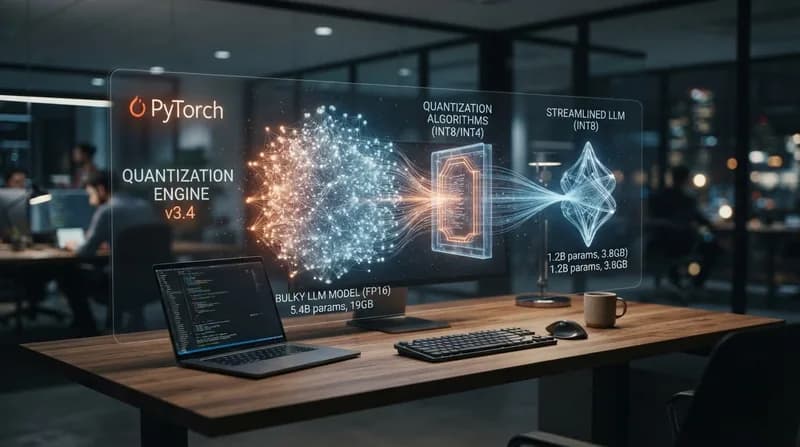
Pe măsură ce modelele de limbaj de mari dimensiuni (LLM) continuă să crească, provocarea de a rula aceste sisteme complexe pe hardware de consum a devenit un obstacol major pentru dezvoltatori. Cuantizarea — procesul de reducere a preciziei ponderilor și activărilor unui model — reprezintă soluția industriei pentru a reduce amprenta de resurse. Totuși, ecosistemul a fost mult timp fragmentat din cauza bibliotecilor incompatibile și a restricțiilor specifice anumitor arhitecturi hardware. Astfel apare Quanto, un nou backend de cuantizare PyTorch de la Hugging Face, conceput special pentru a aduce ordine și simplitate în acest flux de lucru critic.
Spre deosebire de multe soluții existente care limitează utilizatorii la anumite arhitecturi sau platforme hardware, Quanto este construit pentru versatilitate. Acesta operează nativ în modul „eager”, ceea ce înseamnă că este compatibil cu modele non-trasabile și oferă suport pentru o gamă largă de dispozitive, inclusiv GPU-uri CUDA standard și Apple Silicon (MPS). Prin gestionarea automată a inserării „stubs”-urilor de cuantizare și a operațiunilor funcționale, acesta reduce barierele pentru dezvoltatorii care doresc să își optimizeze modelele pentru consumul de memorie și viteză.
Fluxul principal de lucru pentru cuantizare
Quanto simplifică ciclul complex de compresie a modelelor în câțiva pași gestionabili. Procesul începe cu conversia unui model standard cu virgulă mobilă (float) într-o stare cuantizată dinamic. Ulterior, utilizatorii au opțiunea de a-și calibra modelele folosind eșantioane reprezentative pentru a rafina intervalele de activare, asigurându-se că modelul își păstrează performanța chiar și după compresie. Pentru situațiile care necesită o precizie și mai mare, Quanto suportă „Quantization-Aware-Training” (QAT), permițând dezvoltatorilor să ajusteze modelul pe parcursul câtorva epoci pentru a recupera indicatorii de performanță pierduți în procesul inițial de cuantizare.
Odată ce optimizarea este finalizată, pasul final de „înghețare” (freezing) înlocuiește ponderile float cu echivalentele lor întregi. Hugging Face a prioritizat compatibilitatea pe tot parcursul acestui ciclu; ponderile cuantizate rezultate sunt complet compatibile atât cu serializarea standard PyTorch, cât și cu formatul extrem de eficient Safetensors, asigurând astfel că dezvoltatorii pot salva și reîncărca ușor modelele optimizate fără a compromite compatibilitatea cu fluxurile de lucru existente.
Caracteristici cheie și versatilitate hardware
Forța Quanto rezidă în flexibilitatea tehnică și capacitățile de integrare. Biblioteca suportă o gamă variată de lățimi de biți, inclusiv int2, int4, int8 și float8 pentru ponderi, precum și int8 și float8 pentru activări. Această granularitate permite dezvoltatorilor să echilibreze acuratețea și eficiența în funcție de constrângerile hardware-ului țintă. Mai mult, Quanto este conceput pentru a fi compatibil cu „torch.compile”, permițând căi de inferență de înaltă performanță care pot fi accelerate suplimentar prin compilarea modelului.
De ce contează acest lucru
- Hardware agnostic: Funcționează pe CPU, GPU și Apple Silicon, eliminând dependența de hardware specific întâlnită în multe instrumente vechi.
- Integrare facilă: Integrat profund în biblioteca Hugging Face Transformers, permițând implementarea rapidă prin intermediul clasei QuantoConfig.
- Orientat către dezvoltatori: Oferă un API simplificat care gestionează complexitatea tehnică a cuantizării, reducând codul de configurare („boilerplate”) necesar pentru optimizarea modelelor.
- Suport extins: Depășește sfera LLM-urilor, susținând orice modalitate, inclusiv modele audio precum Whisper de la OpenAI, demonstrându-și utilitatea în diverse aplicații AI.
Prin furnizarea unui backend unificat care funcționează constant în întregul ecosistem PyTorch, Quanto este gata să devină alegerea implicită pentru dezvoltatorii care caută să echilibreze puterea AI-ului modern cu realitatea resurselor de calcul limitate. Indiferent dacă dezvoltați pentru dispozitive edge sau optimizați capacitatea serverelor, posibilitatea de a trece rapid între modelele float și cele cuantizate, fără a schimba setul de instrumente, reprezintă un pas semnificativ pentru comunitatea open-source.