Democratizarea antrenării AI la scară largă
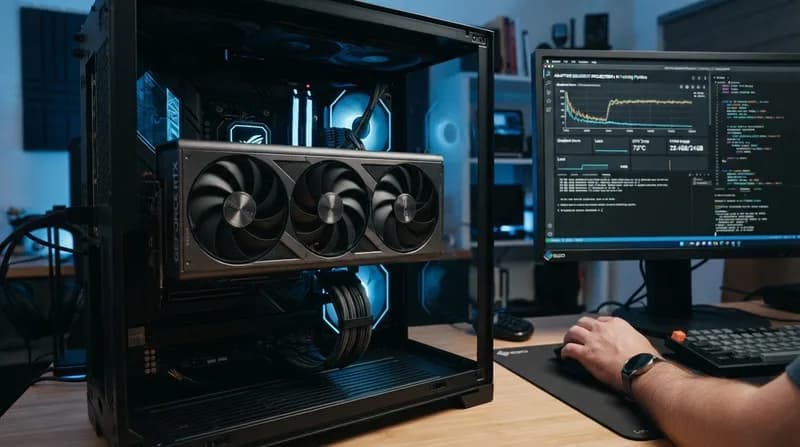
Bariera de intrare în domeniul antrenării modelelor de limbaj de mari dimensiuni (LLM) a fost definită istoric de nevoia de hardware performant. În mod tradițional, antrenarea modelelor cu miliarde de parametri a necesitat clustere de GPU-uri enterprise, izolând cercetarea AI semnificativă de cei care nu dispun de bugete uriașe sau de acces la centre de date masive. Introducerea GaLore (Gradient Low-Rank Projection) schimbă complet această paradigmă, permițând antrenarea unor arhitecturi precum Llama pe hardware performant de consum, cum este NVIDIA RTX 4090.
Prin regândirea fundamentală a modului în care sunt stocați și procesați gradienții, GaLore permite dezvoltatorilor să evite blocajele de memorie asociate de obicei stărilor optimizatorului. Această inovație acționează ca un catalizator pentru democratizarea AI, mutând sarcina antrenării modelelor sofisticate din laboratoarele monolitice în mâinile cercetătorilor și practicienilor independenți.
Mecanismele eficienței memoriei
Eficiența GaLore se bazează pe reducerea strategică a amprentei de memorie asociate stărilor optimizatorului. Optimizatoarele adaptive, precum Adam, sunt cunoscute pentru consumul mare de memorie, stocând volume semnificative de date în timpul procesului de propagare înapoi (backpropagation). GaLore atenuează acest aspect prin proiectarea gradienților într-un subspațiu cu dimensiuni reduse înainte ca aceștia să ajungă la optimizator. Acest truc matematic diminuează considerabil dimensiunea datelor ce trebuie stocate, rezultând într-o reducere raportată a amprentei de memorie cu peste 82,5% pentru stările optimizatorului în timpul ciclului de antrenare.
Pentru a preveni blocarea modelului într-o cale de optimizare limitată, GaLore utilizează un mecanism dinamic de comutare a subspațiilor. Acesta permite modelului să alterneze periodic între diferite proiecții de rang inferior, asigurând robustețea procesului de antrenare și capacitatea de învățare pe toți parametrii. Prin echilibrarea frecvenței acestor comutări, dezvoltatorii pot menține o traiectorie constantă, navigând eficient în compromisul dintre memorie și optimizare.
Sinergia cu optimizarea pe 8 biți
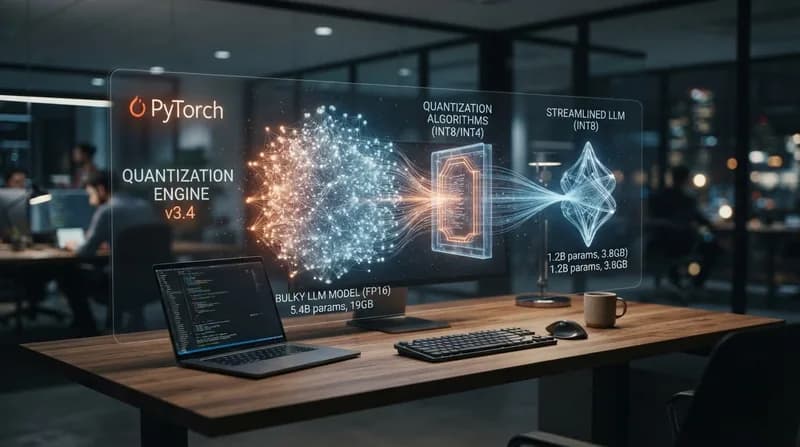
GaLore devine și mai potent atunci când este utilizat alături de optimizatoare cu precizie pe 8 biți. Această combinație folosește cuantificarea pentru a comprima și mai mult stările optimizatorului, gradienții și ponderile modelului, transformându-le din formate standard de 32 de biți (floating-point) în întregi pe 8 biți. În timp ce proiecția GaLore gestionează dimensiunea, integrarea pe 8 biți se ocupă de densitatea preciziei, creând o conductă extrem de eficientă care maximizează utilitatea memoriei VRAM limitate.
Integrarea implică un proces în mai mulți pași: proiecția gradientului, cuantificarea, actualizarea optimizatorului și de-cuantificarea. Pe parcursul acestui flux, GaLore se asigură că actualizările de-cuantificate sunt proiectate înapoi în spațiul original înainte de ajustarea ponderilor. Astfel, în timp ce consumul de memorie este drastic mai mic, integritatea matematică și viteza de convergență a modelului rămân aproape intacte.
De ce este important
- Accesibilitate hardware: Permite antrenarea modelelor cu peste 7 miliarde de parametri pe un singur GPU de consum.
- Economii substanțiale: Realizează o reducere de 82,5% a memoriei pentru stările optimizatorului.
- Integrare facilă: Suport complet în biblioteca Hugging Face Transformers, permițând adoptarea rapidă prin modificarea unor flag-uri simple în TrainingArguments.
- Optimizare flexibilă: Oferă funcții de actualizare per strat (layer-wise), care pot optimiza și mai mult utilizarea memoriei în funcție de nevoile specifice ale arhitecturii.
Implementarea pentru practicieni
Pentru dezvoltatorii care doresc să integreze această metodă în fluxurile lor de lucru existente, procesul este simplificat prin ecosistemul Hugging Face. Prin instalarea bibliotecii `galore-torch` și utilizarea unor versiuni compatibile de `transformers` (v4.39.0 sau ulterioare), utilizatorii pot specifica pur și simplu `galore_adamw` sau `galore_adamw_8bit` în `TrainingArguments`. Acest design asigură faptul că trecerea către o antrenare mai eficientă din punct de vedere al memoriei este o chestiune de configurare, nu o reconstrucție completă a codului, marcând un reper important pentru accesibilitatea în domeniul AI.