Evoluția segmentării unificate
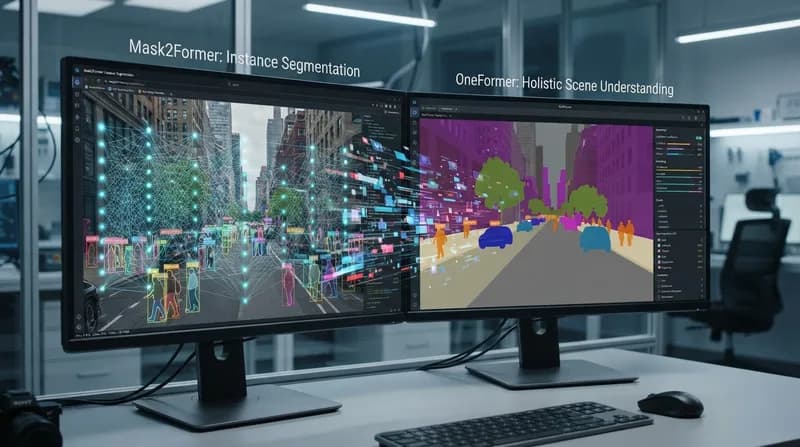
Domeniul computer vision a fost mult timp fragmentat de modele specializate, concepute pentru sarcini unice. În mod tradițional, segmentarea imaginilor necesita arhitecturi distincte pentru a identifica segmentele semantice, contururile instanțelor sau scenele panoptice. Apariția Mask2Former și OneFormer marchează o schimbare de paradigmă către arhitecturi universale, permițând unui singur model să execute toate cele trei tipuri de segmentare cu o precizie ridicată și o eficiență sporită.
Înțelegerea schimbării arhitecturale
Mask2Former a introdus o abordare inovatoare, tratând segmentarea imaginilor ca pe o problemă de clasificare a măștilor. Utilizând un decodor bazat pe Transformer și un set de interogări (query embeddings) care pot fi învățate, modelul poate prezice o colecție de măști binare împreună cu categoriile aferente. Această metodă înlocuiește modulele complexe, specifice fiecărei sarcini, care limitau anterior performanța în timp real și simplitatea arhitecturală. Cadrul rezultat oferă o modalitate mai clară și mai robustă de interpretare a datelor vizuale.
Rolul OneFormer
Bazându-se pe succesul Mask2Former, OneFormer optimizează fluxul de lucru prin introducerea unei strategii de antrenament multi-task. Acesta folosește o abordare bazată pe interogări care unifică reprezentarea internă a diferitelor tipuri de segmentare. Prin antrenarea pe seturi de date diverse, OneFormer învață să facă distincția între „stuff” (regiuni amorfe, cum ar fi cerul sau iarba) și „things” (obiecte distincte, precum mașinile sau persoanele) într-un format de ieșire unitar.
De ce contează
- Eficiență computațională: Reducerea numărului de modele distincte necesare pentru implementare economisește resurse GPU valoroase.
- Interoperabilitate: Aceste modele accelerează ciclurile de dezvoltare, oferind un singur API pentru diverse cerințe de identificare vizuală.
- Performanță sporită: Transformerele unificate beneficiază adesea de învățarea cross-task, permițând modelului să obțină rezultate mai bune în segmentarea semantică prin valorificarea cunoștințelor dobândite din sarcinile la nivel de instanță.
Pentru dezvoltatori și cercetătorii în AI, aceste instrumente marchează tranziția către „modele fundamentale” pentru viziune, unde arhitecturile monolitice și extrem de capabile vor înlocui treptat peisajul fragmentat al instrumentelor AI cu scop limitat.