Lupta semantică pentru transparența AI
În peisajul în continuă schimbare al inteligenței artificiale, termenul „deschis” (open) a devenit o marfă disputată. Departamentele de marketing, laboratoarele de cercetare și factorii de decizie folosesc frecvent sintagma „open source” pentru a descrie modele publicate pe platforme precum Hugging Face. Cu toate acestea, experții din industrie și cercetătorii în drept atrag atenția: simpla lansare a unor seturi de ponderi numerice (weights) nu echivalează cu oferirea transparenței fundamentale cerute de definiția reală a software-ului open source.
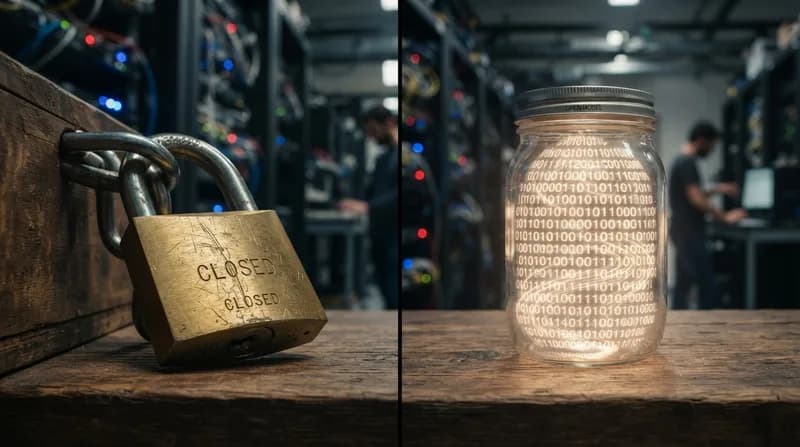
Nucleul problemei rezidă în distincția dintre „open weights” și „open source”. Modelele cu ponderi deschise constau în parametrii și bias-urile finale generate după ce o rețea neurală își încheie antrenamentul. Odată lansate, dezvoltatorii pot descărca, găzdui și ajusta aceste modele pe propriul hardware. Acesta este un avantaj major pentru inferența locală, confidențialitate și evitarea dependenței de un singur furnizor. Totuși, acești parametri reprezintă doar produsul finit, nu și planul de construcție sau materiile prime folosite pentru a-l crea. Adevăratul open source presupune libertatea de a studia, modifica și reproduce un sistem – un nivel de transparență care, în prezent, lipsește majorității modelelor AI lansate.
Deficitul de responsabilitate
Open Source Initiative (OSI) și voci academice marcante, precum James Landay de la Stanford Institute for Human-Centered AI, susțin că modelele cu ponderi deschise oferă doar o fracțiune din datele necesare pentru o responsabilitate deplină. Fără acces la setul de date de antrenament, la documentația despre modul în care au fost curatoriate datele sau la informații despre metodele de aliniere și ajustare pentru siguranță, comunitatea nu poate verifica modul în care aceste modele ajung la concluzii și nici nu poate evalua potențialele prejudecăți (bias-uri) pe care le-ar putea ascunde.
Natura de „cutie neagră” a modelelor cu ponderi deschise rămâne principalul obstacol. Chiar dacă un dezvoltator poate rula un model pe propriul GPU, acesta nu are nicio certitudine dacă modelul a fost antrenat pe materiale protejate prin drepturi de autor sau dacă anumite date sociale relevante au fost omise intenționat. Așa cum sintetizează Landay, modelele open-weight răspund la întrebarea „Pot rula acest lucru?”, dar eșuează să abordeze întrebarea critică: „Pot avea încredere în el?”
Provocările licențierii și controversa OSAID
Încercarea OSI de a codifica aceste cerințe prin intermediul Open Source AI Definition (OSAID 1.0) a declanșat o reacție dură. Criticii, printre care veterani ai mișcării open-source precum Bruce Perens și reprezentanți ai Software Freedom Conservancy, au acuzat organizația de „openwashing” – o diluare a standardelor riguroase ale definiției open source pentru a se adapta realităților actuale din dezvoltarea AI.
Dezbaterea s-a mutat către noi cadre de licențiere, cum este licența Open Model, Data, and Weights (OpenMDW). Susținută de giganți ai industriei precum Microsoft, Meta, Amazon și Nvidia, această inițiativă urmărește tratarea codului, a arhitecturii și a datelor de antrenament ca un singur pachet juridic. În timp ce unii susțin că această abordare este calea pragmatică într-o lume dominată de companii tech proprietare, alții o consideră o încercare de a eluda principiile tradiționale ale libertății software. Rămâne de văzut dacă aceste licențe vor satisface autoritățile de reglementare și comunitatea open-source sau dacă vor deveni doar un nou strat de retorică de marketing.
De ce contează
- Auditarea datelor: Fără acces la datele de antrenament, cercetătorii nu pot identifica erorile de tip bias sau potențiala încălcare a drepturilor de autor.
- Securitate și încredere: Procesele de antrenament proprietare împiedică auditurile de securitate independente asupra alinierii și siguranței modelelor.
- Standardizare: Industria duce lipsă de un consens privind definiția „AI deschis”, ceea ce duce la confuzie în rândul consumatorilor și fragmentarea politicilor.
- Inovație versus control: O mișcare cu adevărat open-source în AI ar putea preveni monopolizarea infrastructurii inteligenței moderne de către un grup restrâns de companii.