Avantajul SetFit
SetFit a devenit rapid un instrument esențial pentru comunitatea de dezvoltatori AI, în special pentru cei care se confruntă cu problema cronică a lipsei datelor etichetate. Prin eficientizarea procesului de „few-shot fine-tuning” pentru Sentence Transformers, SetFit permite modelelor să atingă o precizie ridicată folosind doar un număr redus de exemple. Spre deosebire de abordările bazate pe modele lingvistice mari (LLM), care depind de ingineria complexă și instabilă a prompturilor, SetFit generează embedding-uri complexe direct din mostrele de text, ceea ce face ca antrenarea să fie mai rapidă și mai fiabilă în mediile de producție. Cu peste 100.000 de descărcări lunare și un ecosistem în plină expansiune pe Hugging Face Hub, framework-ul a devenit un standard pentru sarcinile moderne de procesare a limbajului natural (NLP).
Accelerarea throughput-ului cu Optimum Intel
Deși SetFit este eficient prin natura sa, implementarea la nivel de producție rămâne o prioritate pentru echipele enterprise. O nouă colaborare între Hugging Face și Intel Labs oferă o soluție performantă: utilizarea bibliotecii 🤗 Optimum Intel pentru a optimiza modelele SetFit pe procesoarele Intel Xeon. Prin aplicarea cuantizării statice post-antrenare (PTQ), dezvoltatorii pot reduce semnificativ latența modelului și pot crește throughput-ul, menținând în același timp niveluri ridicate de acuratețe.
Optimum Intel valorifică funcțiile avansate de accelerare hardware prezente în procesoarele Intel, inclusiv Advanced Vector Extensions 512 (AVX-512), Vector Neural Network Instructions (VNNI) și Advanced Matrix Extensions (AMX). Aceste extensii permit fluxurilor de lucru de tip deep learning să ruleze mai eficient prin utilizarea acceleratoarelor BFloat16 și INT8 GEMM integrate direct în fiecare nucleu.
Fluxul de lucru pentru cuantizare
Procesul de optimizare a unui model SetFit este conceput pentru a fi simplu. Acesta implică utilizarea Intel Neural Compressor (INC) pentru a converti ponderile de înaltă precizie în reprezentări pe un număr mai mic de biți, precum INT8. Această reducere a preciziei este motorul din spatele câștigurilor de performanță, deoarece scade amprenta de memorie și accelerează calculul.
- Calibrare: Dezvoltatorii trebuie să pregătească un set de date mic pentru calibrare – de regulă aproximativ 100 de mostre reprezentative – pentru a se asigura că modelul își păstrează acuratețea în timpul procesului de cuantizare.
- Implementare: Folosind modulul
INCQuantizerdin cadrul Optimum Intel, modelul trece printr-o cuantizare statică adaptată pentru sarcini NLP. Acest proces este „post-antrenare”, ceea ce înseamnă că nu este necesară nicio reantrenare suplimentară sau un „fine-tuning” complex. - Implementare în producție: Modelul rezultat este o versiune mai ușoară și mai rapidă a originalului, gata de a fi utilizată pe hardware standard Intel Xeon, fără a fi nevoie de acceleratoare specializate.
Evaluarea performanței
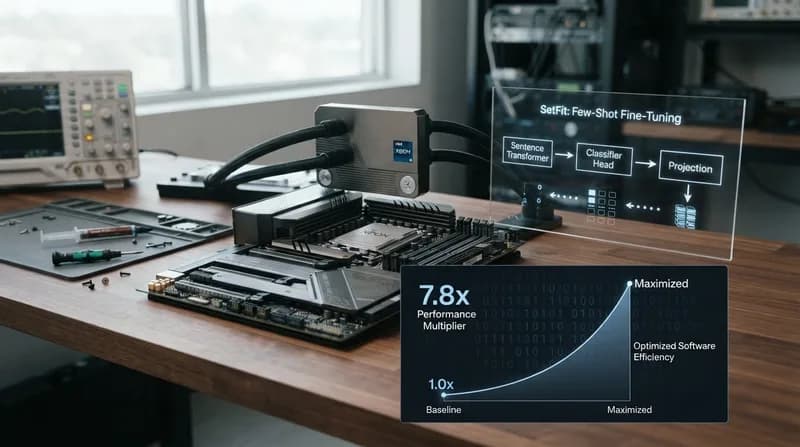
Câștigurile de performanță obținute prin această optimizare sunt considerabile. În comparație cu implementările standard PyTorch și Transformers (fp32), modelul Optimum Intel cuantizat demonstrează o reducere drastică atât a dimensiunii, cât și a latenței. La o dimensiune a lotului (batch size) de unu, modelul optimizat a arătat o îmbunătățire de 3,45 ori a latenței. Mai important, în testele pentru throughput maxim pe diverse dimensiuni ale loturilor, modelul optimizat a atins o viteză de 7,8 ori mai mare față de linia de bază inițială. Este notabil faptul că aceste rezultate au fost obținute fără nicio pierdere perceptibilă în acuratețea setului de test, demonstrând că echipele de producție pot obține economii semnificative de costuri și eficiență fără a compromite inteligența modelului.
De ce este important
Pentru organizațiile care implementează soluții NLP la scară largă, diferența dintre o creștere de 1x și una de 7,8x a throughput-ului se traduce direct în reducerea costurilor pentru servere și într-o experiență mai bună pentru utilizatori. Prin eliminarea decalajului dintre cercetarea AI de înaltă performanță și hardware-ul de server enterprise deja existent, precum Intel Xeon, această optimizare face ca AI-ul sofisticat să fie mult mai accesibil pentru mediile reale de producție, eliminând dependența de clustere masive de GPU-uri pentru sarcinile de inferență.