Revoluționarea antrenamentului distribuit
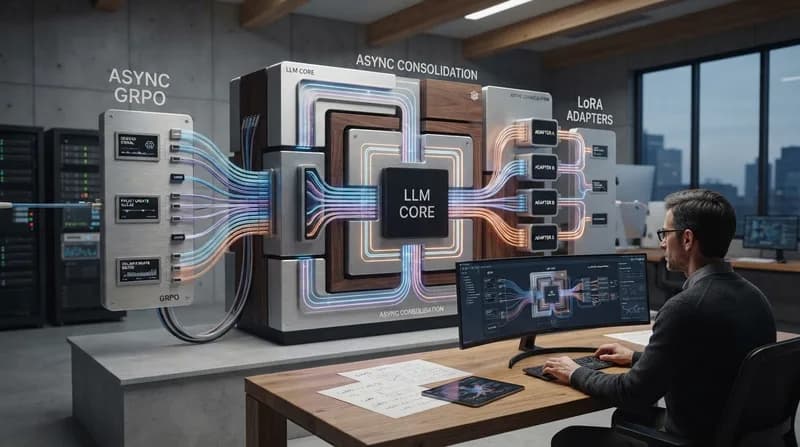
Hugging Face a lansat o metodologie optimizată pentru Group Relative Policy Optimization (GRPO) asincron, combinată cu tehnica Low-Rank Adaptation (LoRA). Prin separarea fazelor de generare și de antrenare, această arhitectură elimină cerințele complexe impuse de NCCL (NVIDIA Collective Communications Library), facilitând considerabil scalarea antrenării modelelor pe resurse de calcul eterogene.
În mod tradițional, antrenarea modelelor lingvistice mari necesită o sincronizare strictă între unitățile GPU, ceea ce duce adesea la blocaje dacă un nod înregistrează întârzieri. Noua abordare schimbă paradigma, utilizând un spațiu central de stocare pentru datele de experiență și un mecanism de tip proxy pentru sincronizarea ponderilor modelului. Această metodă izolează faza de generare, intensivă din punctul de vedere al fluxului de date, de faza actualizării gradienților, permițând dezvoltatorilor să folosească infrastructuri eterogene fără dificultățile specifice orchestrării distribuite clasice.
De ce contează
- Complexitate redusă: Eliminarea dependenței stricte de NCCL scade barierele pentru rularea sarcinilor masive de învățare prin consolidare (reinforcement learning) pe clustere de consum sau pe configurații neomogene.
- Eficiența resurselor: Actualizările asincrone se asigură că unitățile de calcul nu rămân inactive în așteptarea sincronizării, maximizând gradul de utilizare pe tot parcursul ciclului de viață al antrenamentului.
- Flexibilitate: Integrarea LoRA menține amprenta de memorie la un nivel gestionabil, permițând ajustarea fină (fine-tuning) a modelelor precum DeepSeek-R1-Distill-Qwen pe configurații hardware mai accesibile.
Implicațiile pentru comunitatea open-source sunt majore. Pe măsură ce ajustarea fină devine esențială pentru raționamentul specific pe domenii, acest framework democratizează accesul la protocoalele de antrenare bazate pe RL. Permițând rularea acestor sarcini pe arhitecturi standard de tip coadă de joburi, echipele pot scala acum experimentele fără a mai avea nevoie de interconexiuni scumpe și cu lățime de bandă mare, caracteristice sistemelor de supercomputing tradiționale.
Pe măsură ce dezvoltatorii de AI continuă să exploreze limitele modelelor distilate, această actualizare de infrastructură oferă o cale scalabilă de evoluție. Ea reprezintă o tranziție de la mediile de antrenament rigide și monolitice către fluxuri de lucru flexibile și reziliente, care pun preț pe viteza de dezvoltare și pe compatibilitatea hardware în detrimentul sincronizării la nivel de microsecundă.