Inteligenta ArtificialaAnaliza tehnica

Executarea chatbot-urilor AI de înaltă performanță pe GPU-uri AMD: Un ghid tehnic

Publicat
RRedactia ElectricBuzz
Executarea chatbot-urilor AI de înaltă performanță pe GPU-uri AMD: Un ghid tehnic
3 min de citit574 cuvinteRedactia ElectricBuzz

Pe scurt

“Deblochează puterea modelelor de limbaj mari precum Vicuna-13B pe propriul hardware, folosind platforma ROCm de la AMD și cuantizarea inteligentă.”

Democratizarea modelelor de limbaj mari

Peisajul inteligenței artificiale a suferit transformări majore odată cu dezvoltarea modelelor de limbaj mari (LLM) open-source. Deși soluțiile proprietare, precum ChatGPT, au stabilit standardele de performanță, apariția unor modele precum Vicuna — un chatbot open-source cu 13 miliarde de parametri — permite dezvoltatorilor și cercetătorilor să ruleze soluții AI sofisticate local. Dezvoltat în colaborare de UC Berkeley, CMU, Stanford și UC San Diego, Vicuna este o versiune antrenată fin pe modelul de bază LLaMA, folosind un set masiv de date compus din 70.000 de conversații partajate de utilizatori. Acesta oferă performanțe care rivalizează cu modelele proprietare de top, rămânând în același timp accesibil pentru testare independentă.

În trecut, rularea unui model de asemenea dimensiuni necesita hardware de nivel server, având în vedere că modelul standard Vicuna-13B, în precizie fp16, necesită aproape 28 GB de VRAM. Totuși, prin utilizarea cuantizării post-antrenare, în special metoda GPTQ (Generalized Post-Training Quantization), utilizatorii pot acum să comprime aceste modele la o precizie pe 4 biți. Această procedură reduce semnificativ necesarul de memorie, menținând în același timp un nivel ridicat de acuratețe, ceea ce face posibilă implementarea unor soluții AI puternice pe hardware AMD destinat consumatorilor.

Utilizarea AMD ROCm pentru inferență AI

Puntea de legătură între hardware-ul AMD brut și aceste modele avansate este ROCm (Radeon Open Compute). Ca platformă software open-source, ROCm permite GPU-urilor AMD să gestioneze sarcinile intense specifice deep learning-ului. Folosind ROCm, dezvoltatorii pot rula sarcini de lucru standard Pytorch pe hardware compatibil, cum ar fi Radeon RX 6900XT sau seria Instinct MI210, fără a fi nevoie de medii software proprietare specializate.

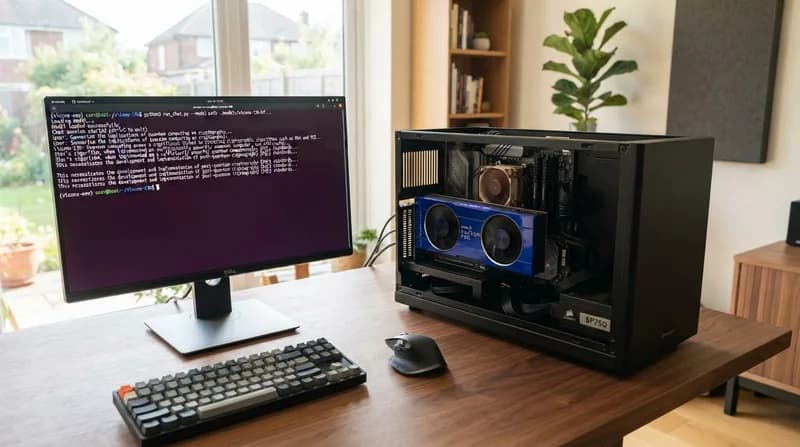
Pentru început, utilizatorii trebuie să se asigure că mediul lor bazat pe Linux este configurat corect; acest lucru presupune, de regulă, instalarea suitei ROCm prin depozitele oficiale de pachete AMD. Utilizarea containerelor Docker preconfigurate cu ROCm și Pytorch 2.0 simplifică procesul, asigurând legătura corectă a nucleelor necesare pentru de-cuantizare și înmulțirea matricelor cu hardware-ul. Această configurație permite versiunii cuantizate pe 4 biți a Vicuna-13B să ruleze fără probleme în cei 16 GB de VRAM ai unei plăci precum RX 6900XT, consumând puțin sub 8 GB de memorie pentru modelul propriu-zis, lăsând suficient spațiu pentru stocarea temporară a intrărilor și ieșirilor.

De ce este important

  • Eficiența costurilor: Rularea modelelor local elimină necesitatea apelurilor API costisitoare și a abonamentelor recurente pentru serviciile AI.
  • Optimizarea memoriei: Cuantizarea GPTQ pe 4 biți reduce necesarul de memorie pentru modelul Vicuna-13B cu peste 70%, făcându-l viabil pentru GPU-urile de top destinate consumatorilor.
  • Versatilitatea hardware: Ecosistemul software ROCm continuă să se extindă, permițând dezvoltatorilor să utilizeze hardware-ul robust de la AMD pentru fluxuri de lucru moderne de AI generativ.
  • Confidențialitatea datelor: Prin găzduirea locală a modelului, utilizatorii păstrează controlul total asupra datelor introduse și a rezultatelor generate, aspect ideal pentru cercetări sensibile sau proiecte creative private.

Perspective și implementare

Capacitatea de a rula un model cu 13 miliarde de parametri pe un singur GPU de consum marchează un moment de referință pentru implementările AI locale. Deoarece performanța LLM-urilor este adesea limitată de lățimea de bandă a memoriei, nu de puterea brută de calcul, modelele cuantizate nu suferă penalizări majore de latență. Utilizatorii pot beneficia acum de interacțiuni eficiente și rapide pentru traduceri, sumarizări și generare de conținut, direct de pe propriile stații de lucru. Pe măsură ce ecosistemul ROCm se maturizează, ne așteptăm la optimizări suplimentare ale nucleelor, ceea ce ar putea reduce bariera de intrare pentru arhitecturi de modele mai complexe și mai mari pe viitor.
SPONSORED
The 5 Best Over-Ear ANC Headphones of 2026, Tested & Ranked
Ghid Cumpărături Recomandat
92/100
Tech si Gadgeturi•12 min de citit

The 5 Best Over-Ear ANC Headphones of 2026, Tested & Ranked

We locked five over-ear ANC picks for 2026 — Sony WH-1000XM6, Bose QuietComfort Ultra 2, Soundcore Space One, Sennheiser Momentum 5, and Apple AirPods Max 2 — then stress-tested them on lab metrics, long-term owner truth, and live street prices.

Articole similare

Articole asemanatoare, ordonate semantic dupa subiect si actualitate.

Meta pregătește „Muse Charm”, un dispozitiv AI de buzunar de 300 de dolari
Inteligenta Artificiala

Meta pregătește „Muse Charm”, un dispozitiv AI de buzunar de 300 de dolari

Se zvonește că Meta se pregătește să lanseze „Muse Charm”, un dispozitiv AI purtabil cu prețul de 300 de dolari, transformând software-ul său de tip agent într-un companion fizic de dimensiunea unui breloc.

Apple se pregătește să intre în cursa AI-urilor autonome: O nouă viziune pentru macOS
Inteligenta Artificiala

Apple se pregătește să intre în cursa AI-urilor autonome: O nouă viziune pentru macOS

Apple dezvoltă un agent AI sofisticat capabil să opereze sistemul de operare macOS, marcând o schimbare strategică către automatizarea proactivă a fluxurilor de lucru complexe.

Nvidia în derivă: Plecarea neașteptată a lui Jensen Huang
Inteligenta Artificiala

Nvidia în derivă: Plecarea neașteptată a lui Jensen Huang

O analiză a crizei corporative de la Nvidia în urma demisiei subite a CEO-ului veteran Jensen Huang, pe fondul unor controverse personale și îngrijorări privind securitatea națională.

Everful, startup-ul care eficientizează lanțurile de aprovizionare, atrage 48,5 milioane de dolari pentru a automatiza achizițiile globale
Inteligenta Artificiala

Everful, startup-ul care eficientizează lanțurile de aprovizionare, atrage 48,5 milioane de dolari pentru a automatiza achizițiile globale

Everful facilitează legătura dintre micii retaileri și producătorii din China printr-o platformă complexă, bazată pe AI, care gestionează întregul lanț de aprovizionare.

Listarea Anthropic: Un angajament pentru evoluția controlată a AI
Inteligenta Artificiala

Listarea Anthropic: Un angajament pentru evoluția controlată a AI

Odată cu debutul istoric al Anthropic pe bursa publică, CEO-ul Dario Amodei întărește angajamentul companiei față de dezvoltarea responsabilă, promițând să prioritizeze controlul uman în detrimentul lansărilor rapide.

Agentul AI Muse de la Meta, sub lupa autorităților: breșe de confidențialitate și scurgeri de date între conturi
Inteligenta Artificiala

Agentul AI Muse de la Meta, sub lupa autorităților: breșe de confidențialitate și scurgeri de date între conturi

Rapoartele interne sugerează că Muse, agentul AI al Meta, expune din greșeală date private ale utilizatorilor și amestecă informații din conversații personale.

Anthropic debutează istoric pe Nasdaq, cu o evaluare de peste 2 trilioane de dolari
Inteligenta Artificiala

Anthropic debutează istoric pe Nasdaq, cu o evaluare de peste 2 trilioane de dolari

Puterea AI Anthropic a intrat oficial pe piața publică, acțiunile deschizând cu un avans surprinzător de 33% față de prețul deja ridicat al IPO-ului.

Google transformă Gemini pentru macOS într-un agent capabil să controleze computerul
Inteligenta Artificiala

Google transformă Gemini pentru macOS într-un agent capabil să controleze computerul

Google introduce funcționalități de tip agent pentru aplicația desktop Gemini pe Mac, permițând AI-ului să navigheze în aplicații, să gestioneze fișiere și să execute fluxuri de lucru complexe direct pe computerul utilizatorului.