Eliminarea prăpastiei dintre viziune și robotică
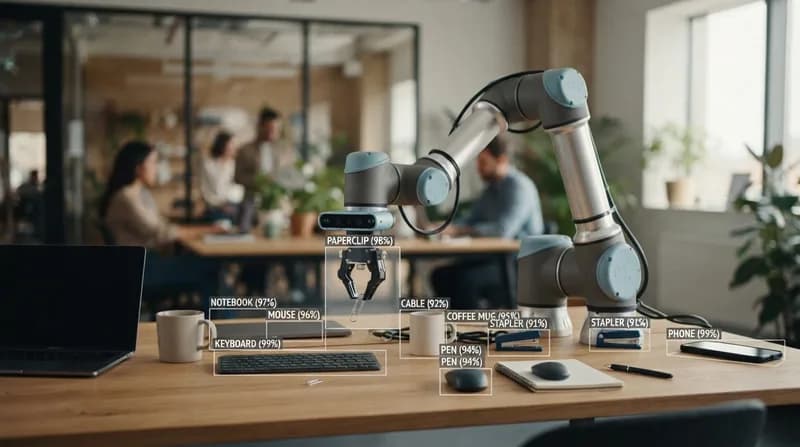
Pentru a funcționa eficient în medii dinamice, roboții au nevoie de mai mult decât mișcări preprogramate; ei trebuie să își perceapă și să își înțeleagă mediul înconjurător. Pollen Robotics, echipa din spatele robotului umanoid open-source Reachy, a făcut un pas important în această direcție prin lansarea pollen-vision. Această nouă bibliotecă open-source oferă o interfață unificată pentru modelele de viziune zero-shot, acționând ca un motor perceptiv care permite roboților să identifice, să localizeze și să interacționeze cu obiecte pe care nu le-au mai întâlnit anterior.
Utilizarea modelelor zero-shot elimină necesitatea unor seturi de date de antrenament laborioase, specifice fiecărei sarcini. Dezvoltatorii pot furniza sistemului o descriere textuală, iar robotul poate încerca localizarea obiectului corespondent în spațiul 3D. Această tranziție către o inteligență „gata de utilizare” reprezintă o evoluție vitală pentru robotică, unde capacitatea de a generaliza între medii diferite determină utilitatea unei mașini.
Motorul: modelele de bază din pollen-vision
Biblioteca se bazează pe trei modele fundamentale, selectate pentru versatilitatea lor și pentru capacitatea de a rula pe hardware de consum standard. Fiecare model joacă un rol specific în crearea unui flux de lucru (pipeline) robust pentru detecție 3D:
1. OWL-VIT (Open World Localization)
Dezvoltat de Google Research, OWL-VIT servește drept principal instrument de localizare în stiva pollen-vision. Acesta efectuează localizarea obiectelor 2D de tip zero-shot, condiționată de text. Atunci când un utilizator introduce o comandă precum „pahar de hârtie”, modelul scanează o imagine RGB și returnează casete de delimitare care identifică poziția obiectului, funcționând similar algoritmilor de detecție tradiționali, dar cu flexibilitatea adăugată a inputului în limbaj natural.
2. Mobile SAM (Segment Anything Model)
Pentru a depăși limitările simplelor casete de delimitare, Pollen Robotics a integrat o versiune ușoară a modelului Segment Anything de la Meta AI. Odată ce OWL-VIT identifică o regiune de interes, Mobile SAM generează măști de segmentare precise. Acest nivel de granularitate este crucial pentru robotică, deoarece permite sistemului să distingă obiectul de fundal, asigurând că calculele de adâncime se bazează strict pe obiectul vizat, nu pe zgomotul din jur.
3. RAM (Recognize Anything Model)
Pentru a optimiza performanța, biblioteca include modelul RAM al OPPO Research Institute. Deoarece timpul de inferență al OWL-VIT crește odată cu numărul de comenzi textuale, interogarea sistemului pentru fiecare obiect posibil este ineficientă. RAM acționează ca un filtru de preprocesare, determinând rapid ce obiecte sunt prezente efectiv în cadru, permițând fluxului de lucru să își concentreze resursele computaționale doar pe interogările relevante.
De ce este important
Inovația centrală a pollen-vision constă în capacitatea de a sintetiza aceste modele într-un flux de lucru 3D funcțional. Calculând centrul unei măști de segmentare și corelându-l cu datele de adâncime ale camerei și matricile intrinseci, biblioteca poate traduce o coordonată de pixel 2D într-o locație precisă (x, y, z) în lumea reală. Această capacitate permite unui efector final robotic să se deplaseze către coordonatele spațiale ale unui obiect și să încerce o prindere fără calibrare prealabilă pe acel articol specific.
Deși în prezent este limitat la poziționare spațială de bază — spre deosebire de estimarea completă a poziției 6D — acest framework pune bazele pentru manipulări robotice complexe. Prin oferirea unui API modular și curat, Pollen Robotics permite cercetătorilor și dezvoltatorilor să implementeze AI vizual sofisticat pe roboți cu doar câteva linii de cod, scăzând semnificativ bariera de intrare pentru construirea agenților fizici autonomi.
Privind spre viitor
Pollen Robotics a precizat că această lansare inițială reprezintă doar un punct de plecare. Provocări actuale, precum detecția inconsistentă a obiectelor, lipsa consistenței temporale între cadre și nevoia unor tehnici de prindere mai avansate, rămân domenii active de dezvoltare. Actualizările viitoare vor include soluții de urmărire a punctelor și metode îmbunătățite pentru generarea unor posturi complexe de prindere, extinzând și mai mult utilitatea bibliotecii în domeniul manipulării autonome.