Provocarea contextului în continuă expansiune
Infrastructura AI traversează un punct de cotitură. Pe măsură ce organizațiile fac tranziția de la interacțiuni simple de tip chatbot către raționamente complexe, agenți autonomi și ferestre de context de mari dimensiuni, cererea de memorie crește exponențial. Principala piedică este memoria cache de tip cheie-valoare (KV) — o structură de date care stochează informațiile generate anterior pentru a evita calculele redundante. În prezent, majoritatea acestor date sunt stocate în memoria GPU sau în memoria sistemului, ambele fiind costisitoare și limitate ca spațiu, ceea ce creează un blocaj major pentru implementările la scară largă.
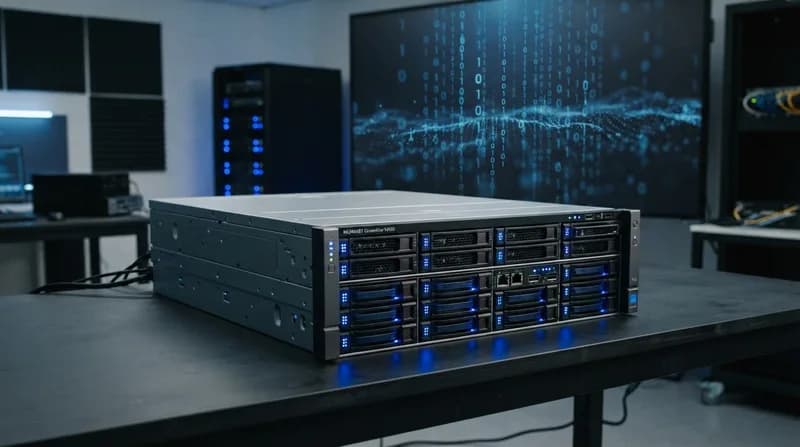
Deși stocarea tradițională oferă capacitatea necesară, aceasta depinde adesea de rute de date lente, gestionate de procesor. Acest lucru introduce latențe care mențin acceleratoarele de înaltă performanță inactive, în așteptarea datelor necesare pentru finalizarea sarcinilor de inferență. Soluția Huawei pentru această fricțiune arhitecturală este noul sistem OceanStor M900 Context Memory Storage, o platformă creată pentru a regândi modul în care clusterele de inferență gestionează contextul pe termen lung.
Arhitectura OceanStor M900
Prezentat în cadrul evenimentului Huawei Connect 2026, OceanStor M900 funcționează ca un nivel dedicat de stocare pentru context, extinzând efectiv memoria cache KV dincolo de limitările memoriei locale a acceleratorului. Prin utilizarea interconectării de mare viteză UnifiedBus, sistemul permite partajarea resurselor de memorie în întregul cluster de calcul. Această configurație creează un spațiu de stocare masiv, pe mai multe niveluri, capabil să scaleze până la 64 PB, oferind unităților de procesare neurală (NPU) acces la o cantitate de context semnificativ mai mare decât până acum.
Secretul performanței sale constă în unitatea de stocare specializată ASU (Accelerated Storage Unit). Acest hardware integrează procesorul, rețeaua și controlerul de stocare într-o singură unitate. Prin utilizarea semanticii native KV, sistemul permite NPU-urilor să preia datele cache într-o singură etapă (single hop), eliminând overhead-ul cauzat de conversia protocoalelor tradiționale sau de transferurile intensive prin procesor. Această optimizare ar putea reduce latența de acces la aproximativ 60 de microsecunde, dublând teoretic rata de procesare a token-urilor și reducând semnificativ timpul până la primul token în sarcinile de lucru complexe, precum programarea sau raționamentul logic.
De ce contează
- Latență redusă: Reducerea timpului de acces la 60 de microsecunde influențează direct capacitatea de răspuns a agenților AI.
- Scalabilitate: Prin activarea unui pool de memorie partajată, infrastructura poate procesa seturi de date mult mai mari decât cele limitate de memoria RAM a GPU-ului.
- Eficiență economică: Sistemul oferă o anduranță de până la 24 de scrieri pe disc pe zi, promițând o durată de viață de 16 ori mai mare decât cea a SSD-urilor standard, ceea ce reduce costurile de mentenanță pe termen lung.
- Design holistic: Această abordare semnalează o schimbare în industrie, către tratarea calculului, memoriei și rețelei ca un flux de lucru unificat, nu ca entități separate.
În final, OceanStor M900 subliniază o direcție mai amplă în peisajul hardware AI: infrastructura care susține aceste modele evoluează către o eră în care recuperarea și păstrarea contextului sunt la fel de vitale precum performanța brută de calcul. Prioritizând gestionarea ciclului de viață al datelor cache, Huawei își poziționează hardware-ul pentru a ține pasul cu următoarea generație de aplicații AI agentice.