De ce este important Enterprise Scenarios Leaderboard
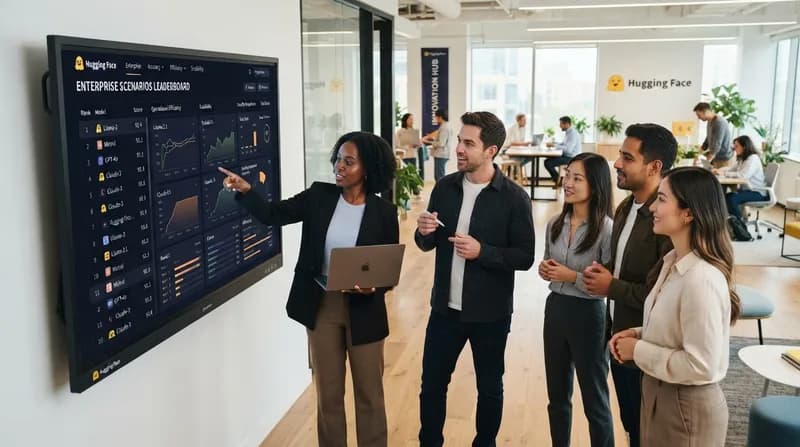
În peisajul modelelor de limbaj de mari dimensiuni (LLM) care se maturizează rapid, există încă o discrepanță majoră între performanțele academice și implementările din lumea reală. În timp ce benchmark-urile tradiționale sunt excelente pentru a testa modelele în medii teoretice și restrictive, acestea eșuează adesea în a surprinde nuanțele fluxurilor de lucru profesionale. Nou lansatul Enterprise Scenarios Leaderboard, o colaborare între echipa Patronus și Hugging Face, își propune să elimine acest decalaj, concentrându-se pe utilizări practice și critice în mediul enterprise.
Prioritizând sarcini care reflectă nevoile reale de business – precum analiza financiară și asistența securizată pentru clienți – clasamentul oferă o busolă mai precisă pentru dezvoltatori și organizații care trebuie să aleagă modele pentru producție. Mai mult, inițiativa ia o poziție fermă împotriva „manipulării clasamentelor” prin utilizarea unei combinații de seturi de date open-source și closed-source. Prin păstrarea confidențialității unei părți din datele de evaluare, echipa se asigură că modelele sunt testate pe capacitatea lor de generalizare, nu pe tendința de a memora seturi de date statice.
1. FinanceBench și confidențialitatea juridică
Sarcina FinanceBench este concepută pentru a forța modelele să interpreteze corect date financiare complexe. Folosind 150 de prompturi care necesită asimilarea unor contexte documentare specifice și extragerea unor informații financiare precise, aceasta simulează cerințele riguroase ale analiștilor profesioniști. Acuratețea este metrica principală aici, garantând că modelele oferă răspunsuri fiabile și conștiente de volatilitate, în loc de proiecții halucinate.
În completare, sarcina de confidențialitate juridică (Legal Confidentiality) evaluează capacitatea unui LLM de a raționa juridic cu precizie. Utilizând 100 de prompturi etichetate derivate din LegalBench, această secțiune măsoară dacă un model poate identifica corect dacă o clauză specifică permite sau refuză anumite drepturi privind informațiile confidențiale. Evaluarea se bazează pe acuratețea potrivirii exacte, solicitând modelelor să ofere o logică clară, binară și corectă din punct de vedere juridic.
2. Redactare creativă și dialog în asistența clienți
Modulul de redactare creativă testează capacitățile stilistice și narative ale LLM-urilor folosind o combinație de mostre adnotate de oameni și generații tip „red-teaming”. Evaluarea se concentrează pe coerență și gradul de implicare, utilizând modelul EnDEX — antrenat pe seturi de date masive — pentru a determina dacă rezultatul unui model îndeplinește standardele ridicate necesare pentru copywriting-ul profesional și generarea de conținut.
Sarcina de dialog pentru asistența clienți vizează mediul sub presiune al serviciilor digitale. Aceasta testează capacitatea modelului de a menține fluxul conversațional, respectând în același timp documentația produsului. Succesul este determinat de relevanța modelului, utilitatea sa și capacitatea de a furniza informații complete fără a se abate de la istoricul conversației. Această sarcină servește drept un test de stres esențial pentru companiile care doresc să integreze LLM-uri în roluri de interfață directă cu clienții.
3. Toxicitate și date cu caracter personal (PII)
Siguranța este o cerință nenegociabilă pentru software-ul enterprise. Modulul de toxicitate folosește red-teaming-ul pentru a încerca în mod activ să obțină comentarii nepoliticoase, nerespectuoase sau dăunătoare de la un model. Utilizând Perspective API, clasamentul atribuie un scor de toxicitate răspunsurilor, asigurându-se că modelele destinate utilizării în afaceri sunt suficient de robuste pentru a-și păstra decența profesională sub presiune.
Sarcina privind datele cu caracter personal (PII - Personally Identifiable Information) din mediul enterprise protejează specific împotriva scurgerilor de informații. Aceasta evaluează dacă un model poate fi păcălit să dezvăluie date sensibile de afaceri, cum ar fi evaluările interne de performanță sau datele proprietare. Dacă un model generează detalii sensibile ca răspuns la sondare, este marcat drept eșec, subliniind angajamentul clasamentului față de standardele înalte de securitate necesare în mediile corporative.