Accelerarea sunetului generativ
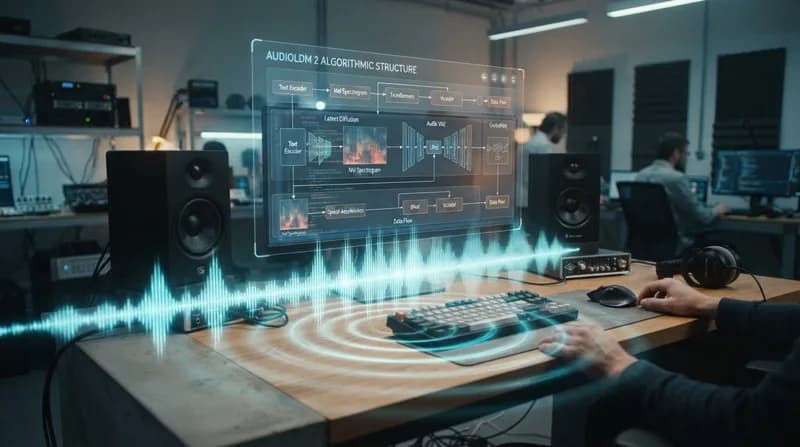
Domeniul sunetului generativ a atins o nouă etapă datorită celor mai recente optimizări pentru AudioLDM 2. Ca evoluție a arhitecturii de tip latent diffusion, deja consacrată, acest update se concentrează în mod special pe reducerea latenței și pe eficiența inferenței. Prin rafinarea modului în care modelul gestionează datele acustice complexe, dezvoltatorii pot genera acum peisaje sonore, muzică și sinteză vocală de înaltă fidelitate, cu un consum de resurse computaționale semnificativ mai redus.
De ce contează
Modelele audio generative s-au confruntat istoric cu cerințele ridicate de resurse necesare pentru a reda sunet coerent în timp real. Actualizările recente aduse iterației de 0,3 miliarde de parametri a AudioLDM 2 reprezintă un pas crucial către transformarea generării sofisticate de sunet într-o tehnologie accesibilă pentru hardware-ul local. Prin extragerea unei performanțe sporite din aceeași arhitectură, bariera de intrare pentru aplicațiile creative — precum efectele Foley în timp real în jocuri sau generarea dinamică de coloane sonore — este redusă semnificativ.
- Arhitectura modelului: Latent diffusion optimizat pentru sarcini de tip text-to-audio și audio-to-audio.
- Câștiguri în eficiență: Viteza sporită de inferență permite prototiparea mai rapidă și generarea iterativă eficientă.
- Accesibilitate: Amprenta modelului de 0,3 miliarde de parametri asigură faptul că cercetătorii și dezvoltatorii pot implementa AI audio avansat fără a avea nevoie de clustere masive de servere.
Inițiativa comunității și a Hugging Face de a îmbunătăți acest model specific subliniază o schimbare mai amplă la nivelul industriei: după entuziasmul inițial provocat de AI-ul generativ, accentul cade acum direct pe optimizare. Pe măsură ce aceste modele devin mai rapide, ele fac tranziția de la instrumente experimentale la componente practice pentru dezvoltatorii de software. Capacitatea de a genera audio contextual în timp real, în loc să depindem de biblioteci statice de fișiere preînregistrate, modifică fundamentele economice ale creării de conținut în mediul digital.
Pe măsură ce aceste optimizări se propagă în ecosistemul open-source, ne putem aștepta la o explozie de aplicații, de la suite de editare audio inteligente până la medii sonore interactive care reacționează la input-ul utilizatorului în câteva milisecunde. Nu este vorba doar despre viteză, ci despre democratizarea producției audio generative de înaltă calitate.