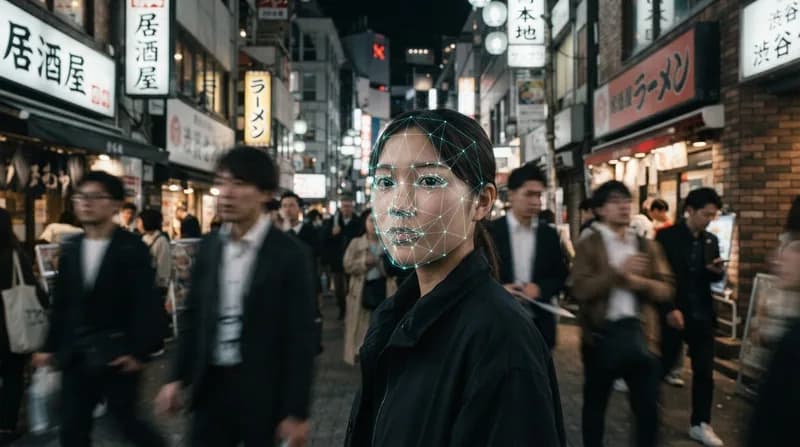
Evoluția inteligenței vizuale
În peisajul aflat într-o expansiune rapidă al viziunii artificiale (computer vision), segmentarea imaginilor de tip „zero-shot” devine un punct de cotitură. Valorificând puterea modelului CLIP – un model de bază antrenat pe volume masive de perechi imagine-text – această tehnologie permite sistemelor să identifice și să izoleze obiecte în fotografii pe baza unor instrucțiuni text descriptive. Spre deosebire de modelele de segmentare tradiționale, care necesită mii de exemple etichetate manual pentru a recunoaște categorii specifice, modelele „zero-shot” interpretează limbajul pentru a-și ghida atenția vizuală.
Arhitectura din spatele acestui proces mapează reprezentările vectoriale ale textului și caracteristicile imaginii într-un spațiu vectorial comun. Atunci când un utilizator introduce o interogare, modelul calculează similitudinea dintre pixelii vizuali și reprezentarea textuală. Această abordare elimină blocajul creat de adnotarea manuală a datelor, permițând sistemelor să segmenteze obiecte rare sau necunoscute anterior cu o precizie remarcabilă, direct din momentul activării.
De ce este important
- Costuri reduse: Dezvoltatorii nu mai au nevoie de seturi de date extinse pentru fiecare clasă nouă de obiecte pe care doresc să o urmărească.
- Flexibilitate dinamică: Utilizatorii pot schimba ținta segmentării în timp real, simplu prin actualizarea instrucțiunii text, ceea ce face tehnologia ideală pentru viziunea robotică și aplicațiile de realitate augmentată (AR).
- Aplicabilitate vastă: De la imagistica medicală pentru identificarea tumorilor, până la robotica industrială pentru sortarea inventarului diversificat în depozite, potențialele cazuri de utilizare sunt numeroase.
Tranziția către capabilitățile „zero-shot” marchează o schimbare în modul în care AI înțelege contextul. Prioritizând înțelegerea lingvistică, ne apropiem de sisteme vizuale universale care nu doar „văd” pixeli, ci înțeleg cu adevărat conținutul unei imagini. Pe măsură ce aceste modele devin mai eficiente, ne putem aștepta la integrarea lor în dispozitive de tip edge, aducând viziunea artificială avansată în hardware-ul cotidian și în electronicele de consum. Viitorul procesării imaginilor nu înseamnă doar antrenarea unor modele mai mari, ci construirea unor modele suficient de versatile pentru a executa orice instrucțiune oferită de utilizator.