Reducerea decalajului de fiabilitate
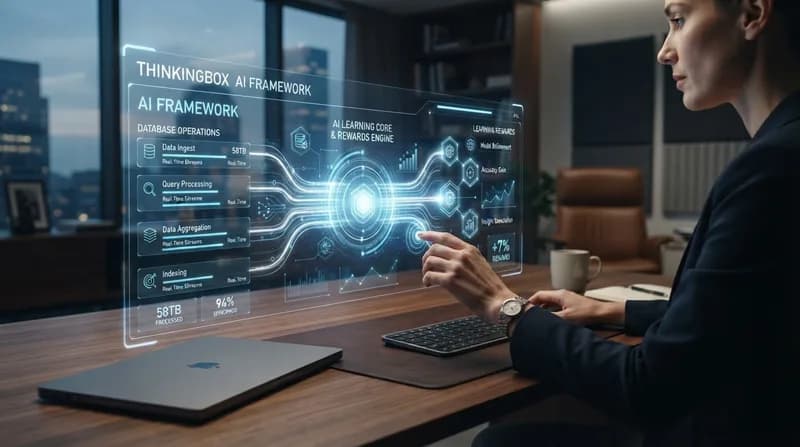
Trecerea agenților AI de la stadiul de chatbot experimental la cel de instrumente funcționale de business a fost îngreunată de o problemă persistentă: lipsa consistenței în fluxurile de lucru cu stare (stateful). Microsoft introduce ThinkingBox, un framework bazat pe cercetare care abordează această problemă prin crearea unui mediu sandbox, în care agenții AI sunt antrenați să gestioneze procese de business complexe, cu mai mulți pași, având o precizie ridicată.
În loc să se bazeze pe evaluări standard bazate pe text, ThinkingBox utilizează o abordare axată pe baze de date. Prin transformarea stărilor bazelor de date în recompense pentru învățarea prin consolidare (reinforcement learning - RL), framework-ul permite agenților să înțeleagă consecințele concrete ale acțiunilor lor. Dacă un agent finalizează corect o tranzacție sau actualizează o înregistrare în mediul sandbox, acesta primește o recompensă pozitivă, învățând astfel „de ce”-ul din spatele unor proceduri tehnice specifice, dincolo de simpla predicție lingvistică.
De ce contează
- Stăpânirea stărilor (Stateful Mastery): Majoritatea modelelor AI întâmpină dificultăți cu memoria în fluxurile de lucru lungi; ThinkingBox obligă agenții să țină cont de evoluția stărilor din baza de date.
- Succes măsurabil: Folosind rezultatele obiective ale bazelor de date ca metrică, framework-ul depășește evaluările subiective, stabilind indicatori de performanță cuantificabili.
- Integrarea în mediul de business: Această metodologie este concepută special pentru a pregăti agenții pentru mediul exigent al software-ului enterprise, unde un apel API sau o interogare SQL incorectă poate avea consecințe operaționale grave.
Cercetarea subliniază că succesul singular nu reprezintă un indicator al fiabilității. Expunând modelele la o varietate mare de scenarii cu stare, ThinkingBox se asigură că agenții pot corecta erorile și pot gestiona nuanțele logicii de business din lumea reală. Această tranziție de la inferența pasivă la rezolvarea activă a problemelor, bazată pe recompense, marchează o schimbare crucială în modul în care reducem distanța dintre modelele fundamentale și asistenții digitali de încredere.