Evoluția alinierii preferințelor
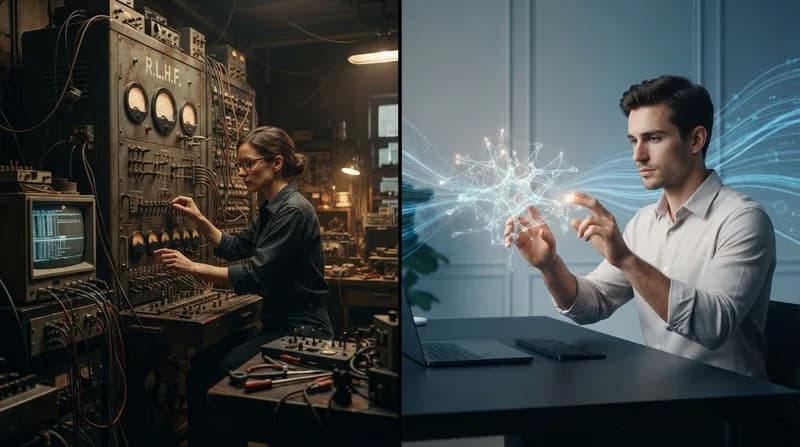
În ecosistemul în plină maturizare al modelelor lingvistice mari (LLM), diferența dintre un model brut și un asistent util, aliniat la nevoile umane, rezidă adesea în procesul de ajustare fină (fine-tuning). Hugging Face a evidențiat recent progrese semnificative în utilizarea metodei Direct Preference Optimization (DPO), o abordare care simplifică alinierea răspunsurilor modelului la așteptările utilizatorilor. Prin evitarea complexității metodelor tradiționale de tip Reinforcement Learning from Human Feedback (RLHF), DPO oferă o cale mai eficientă și mai stabilă către performanțe superioare.
Această schimbare este exemplificată cel mai bine de modelul Zephyr-7b-beta. Folosind DPO, dezvoltatorii pot antrena modele mai compacte, de 7 miliarde de parametri, care oferă rezultate ce rivalizează cu sisteme considerabil mai mari. Această democratizare a alinierii de înaltă performanță asigură faptul că procesul de ajustare nu mai este un avantaj exclusiv al organizațiilor cu resurse computaționale masive.
De ce contează acest aspect
- Eficiență computațională: DPO elimină necesitatea antrenării unui model de recompensă auxiliar, reducând considerabil barierele de intrare pentru dezvoltatori.
- Stabilitate: Metoda evită instabilitatea numerică întâlnită frecvent în fazele de optimizare a politicilor (proximal policy optimization) din cadrul RLHF-ului standard.
- Performanța modelului: Modelele mai mici și optimizate, precum Zephyr, demonstrează că numărul de parametri devine secundar în raport cu calitatea datelor de aliniere și a procesului de optimizare utilizat în timpul antrenamentului.
Pe măsură ce industria se orientează către agenți specializați, capacitatea de a ajusta rapid comportamentul modelelor fără costuri computaționale prohibitive devine vitală. Angajamentul continuu al Hugging Face față de acest cadru de lucru oferă comunității open-source posibilitatea de a rafina comportamentul AI, asigurându-se că modelele nu sunt doar capabile să genereze text, ci sunt și adaptate pentru a urma instrucțiuni nuanțate, centrate pe om. Această abordare marchează un pivot esențial către o dezvoltare AI mai agilă, transparentă și eficientă din punct de vedere al costurilor, stabilind un nou standard pentru optimizarea modelelor viitorului.