Revoluționarea vitezei în AI generativ
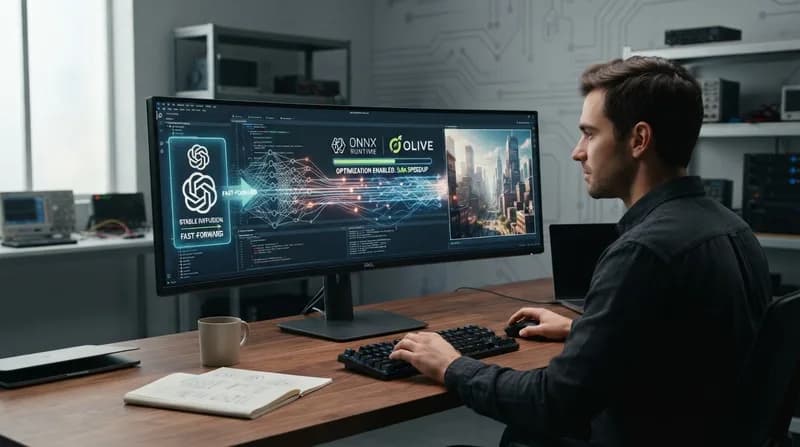
Căutarea performanței în timp real pentru AI generativ a atins un punct de referință important prin integrarea ONNX Runtime și Olive în fluxul de lucru Stable Diffusion. Prin optimizarea modelelor SDXL Turbo și SD Turbo, dezvoltatorii pot obține acum viteze de inferență fără precedent, aducând generarea de imagini de înaltă fidelitate mai aproape de performanța fără latență pe hardware-ul destinat consumatorilor.
Această strategie de optimizare se concentrează pe accelerarea agnostic-hardware, permițând utilizatorilor să exploateze puterea ONNX Runtime pentru a executa modele complexe cu o eficiență sporită. Utilizarea Olive, un set de instrumente intuitiv pentru optimizarea modelelor, face ca procesul de cuantizare și compilare a acestor modele de difuzie să devină mult mai accesibil pentru cercetători și ingineri.
De ce contează
- Latență redusă: Îmbunătățiri drastice ale timpului de răspuns inițial și ale vitezei de generare a imaginilor.
- Flexibilitate hardware: Performanță sporită pe o gamă variată de configurații GPU.
- Fluxuri de lucru simplificate: Olive simplifică procesul, altădată intimidant, de reglare a modelelor, făcând AI-ul generativ de înaltă performanță mai accesibil.
Esența acestui progres rezidă în capacitatea de a compila modelele de difuzie în grafuri executabile extrem de eficiente. Prin reducerea overhead-ului asociat de obicei execuției bazate pe PyTorch, aceste instrumente asigură funcționarea modelelor precum SDXL Turbo la potențialul lor maxim. Acest lucru este esențial pentru aplicațiile în timp real unde fiecare milisecundă contează, cum ar fi instrumentele de design interactiv și platformele de creare de conținut live.
Mai mult, disponibilitatea comunității pentru componente optimizate — cum ar fi remediile pentru SDXL VAE — completează aceste îmbunătățiri arhitecturale. Pe măsură ce dezvoltatorii continuă să itereze pe aceste fluxuri de desfășurare, bariera de intrare pentru AI generativ de înaltă performanță continuă să scadă. Această schimbare marchează maturizarea ecosistemului AI, mutând accentul de la performanța teoretică a modelelor către viteza de inferență practică, gata de producție, care poate fi implementată pe o gamă largă de medii de calcul.