O bornă pentru AI-ul multilingv
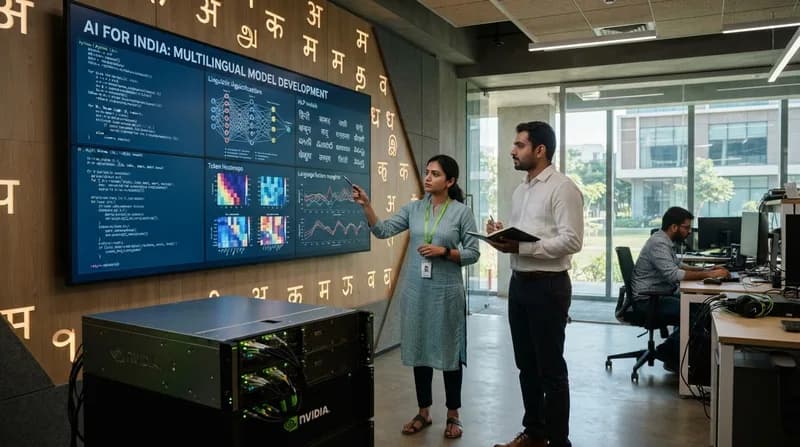
Peisajul modelelor lingvistice mari se schimbă pe măsură ce cercetătorii abordează discrepanțele digitale pentru limbile din India. Printr-un parteneriat strategic, NVIDIA și Bodhan AI au dezvăluit un progres semnificativ: un model de 8 miliarde (8B) de parametri, optimizat special pentru traduceri performante. Această lansare reprezintă un succes tehnic, susținut de un volum fără precedent de date de antrenament — 2,8 trilioane de tokenuri — care asigură modelului o înțelegere nuanțată a diverselor dialecte regionale și structuri lingvistice.
Puterea fluxurilor de date open-source
În centrul acestui proiect se află un flux de lucru open-source pentru generarea de date, care soluționează deficitul cronic de corpusuri de antrenament de înaltă calitate pentru limbile non-engleze. Prin utilizarea generării de date sintetice și a unei selecții riguroase, echipa a reușit să creeze seturi de date masive care păstrează integritatea gramaticală și relevanța culturală. Această abordare cu acces liber oferă dezvoltatorilor din întreaga lume posibilitatea de a experimenta și de a implementa instrumente de traducere care, anterior, erau restricționate de barierele datelor proprietare.
De ce contează acest demers
- Echitate lingvistică: Oferă instrumente sofisticate pentru peste un miliard de vorbitori, facilitând o mai bună incluziune digitală în țările în curs de dezvoltare.
- Scalabilitate tehnică: Demonstrează că modelele eficiente de 8B parametri, antrenate pe seturi de date masive și bine gestionate, pot surclasa modele mult mai mari, dar mai puțin specializate.
- Colaborare deschisă: Prin publicarea fluxului de lucru pentru date, inițiativa accelerează capacitatea comunității științifice de a aborda modelarea limbilor cu resurse reduse.
Integrarea modelului „indic-translate” în ecosistemul AI mai larg marchează o orientare către sinergia dintre hardware-ul și software-ul de înaltă utilitate, adaptate pe domenii specifice. Pe măsură ce benchmark-urile continuă să se îmbunătățească, acest proiect devine un punct de referință pentru modul în care antrenamentul direcționat — în detrimentul forței brute bazate pe numărul de parametri — devine cea mai eficientă cale pentru implementarea AI la nivel local. Se așteaptă ca iterațiile viitoare să rafineze viteza traducerilor în timp real, transformând acest model într-o piesă fundamentală pentru instrumentele de comunicare destinate utilizatorilor finali.