Evoluția rulării locale a modelelor AI
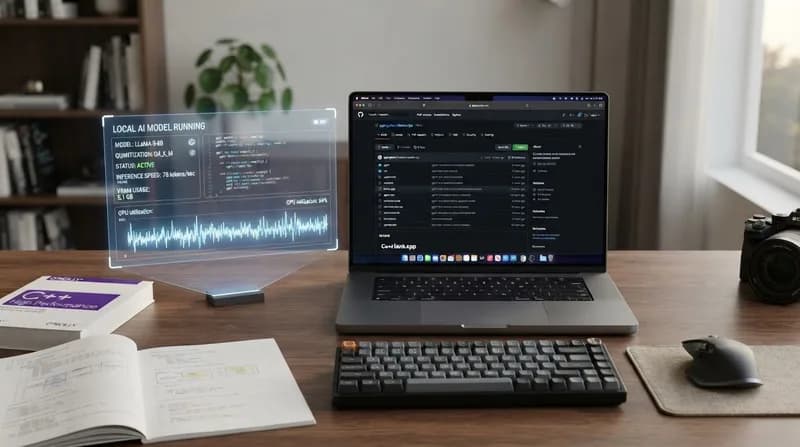
De la apariția sa, acum aproximativ trei ani și jumătate, llama.cpp a schimbat fundamental modul în care dezvoltatorii interacționează cu modelele lingvistice mari (LLM). Prin prioritizarea portabilității C/C++ și a tehnicilor avansate de cuantizare, platforma a transformat tehnologia AI de înaltă performanță dintr-un lux rezervat mediului enterprise într-o capacitate accesibilă pe hardware-ul comercial obișnuit. Astăzi, proiectul atinge o etapă semnificativă de maturitate prin lansarea versiunii 1.0.0, semnalând o nouă eră a stabilității pentru ecosistemul de aplicații care se bazează pe interfața sa robustă.
Trecerea la v1.0.0 nu este doar o recunoaștere simbolică; reprezintă un angajament formal față de dezvoltatorii și proiectele terțe care utilizează arhitectura sa. Prin adoptarea unui sistem strict de versiune semantică, echipa stabilește limite clare pentru compatibilitatea API și ABI. Această tranziție garantează că, pe măsură ce AI-ul local devine tot mai important pentru confidențialitatea datelor și calculul cotidian, dezvoltatorii se pot baza pe o fundație predictibilă, fiabilă și stabilă pentru fluxurile lor de lucru.
1. llama.cpp v1.0.0
În centrul acestei lansări se află motorul principal de inferență, care continuă să ofere o flexibilitate inegalabilă pe întreg ecosistemul de calcul. Conceput pentru eficiență, llama.cpp permite rularea unor modele LLM multimodale masive pe o gamă variată de dispozitive, de la laptopuri ușoare până la servere puternice. Lansarea v1.0.0 include biblioteca libllama și headerele publice aferente, oferind stabilitatea necesară integrărilor de nivel enterprise. Cu suport pentru peste 150 de variante de arhitecturi de modele și o gamă completă de metode de decodare speculativă, acesta rămâne etalonul pentru inferența de înaltă performanță.
2. ggml v1.0.0
Pilonul care susține capabilitățile de inferență este biblioteca de tensori ggml. Acest proiect servește drept coloană vertebrală pentru operațiunile de machine learning, fiind conceput special pentru a rula pe aproape orice configurație hardware. Prin abstractizarea complexității accelerării hardware specifice prin sistemul său dedicat de backend, ggml permite dezvoltatorilor să compileze codul ML ca biblioteci dinamice, încărcabile. Această alegere de design asigură optimizarea performanței în timpul rulării, indiferent de arhitectura țintă, fie că este vorba despre sarcini GPU specializate sau execuție eficientă pe CPU.
De ce contează
- Stabilitate: Introducerea versiunii semantice (MAJOR.MINOR.PATCH) oferă un cadru clar pentru gestionarea modificărilor majore, esențial pentru dezvoltarea software la scară largă.
- Portabilitate: Proiectul rămâne extrem de accesibil, cu suport pentru Windows, macOS, Linux, Android și iOS, prin intermediul managerelor de pachete precum Homebrew, Conda-forge și Winget.
- Independență față de hardware: Prin colaborări extinse, echipa a asigurat suport pentru principalii jucători din industrie, inclusiv NVIDIA, AMD, Qualcomm, Arm, IBM și Intel, garantând că motorul va rămâne relevant pe termen lung.
Perspective și implicații
Privind spre viitor, echipa de dezvoltare se concentrează pe consolidarea infrastructurii pentru a menține standardele ridicate ale proiectului. Utilizând instrumente de integrare continuă (CI) și extinzând rețeaua de self-hosted runners, echipa se asigură că fiecare actualizare a ramurii principale menține o corectitudine strictă. Pe măsură ce preocupările legate de confidențialitate orientează tot mai mulți utilizatori către soluții AI care rulează local, maturizarea acestor biblioteci marchează punctul critic în care codul din sfera cercetării trece către produse software profesionale, fiabile și ușor de întreținut. Direcția este clară, iar accentul rămâne pus pe transparență, control arhitectural și inovație susținută de comunitate.