Convergența dintre modelele Transformer și antrenarea descentralizată
În peisajul AI actual, capacitatea de a antrena modele de mari dimensiuni fără centralizarea unor volume masive de date sensibile a devenit o cerință critică pentru organizațiile preocupate de confidențialitate. O nouă integrare puternică face legătura între ecosistemul robust de modele Transformer de la Hugging Face și puterea descentralizată a framework-ului Flower (flwr). Această sinergie permite dezvoltatorilor să realizeze fine-tuning pentru modele complexe – precum arhitectura populară DistilBERT – pe mai mulți clienți distribuiți, asigurând astfel că datele brute rămân localizate, fiind partajate doar actualizările modelului.
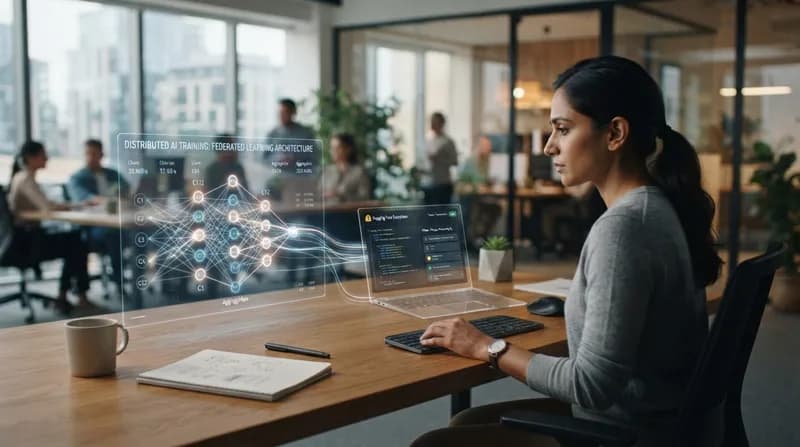
Această implementare marchează o schimbare în modul în care inginerii percep ciclul de viață al antrenării modelelor. Prin utilizarea unei strategii de învățare federată, dezvoltatorii nu mai trebuie să încarce seturi de date brute într-un depozit central. În schimb, modelul „călătorește” către date, învață din informațiile locale și transmite doar parametrii învățați înapoi către un server. Această abordare este transformatoare pentru sectoare care gestionează date text sensibile, cum ar fi sănătatea sau finanțele, unde antrenarea centralizată tradițională implică riscuri semnificative privind confidențialitatea datelor.
Construirea fluxului de lucru federat
Pentru implementarea acestei arhitecturi, fluxul de lucru se bazează pe un set standard de dependențe, incluzând bibliotecile „transformers” și „datasets” de la Hugging Face, cuplate cu framework-ul Flower. Procesul începe cu configurarea conductei de date; utilizând biblioteca „datasets” de la Hugging Face, utilizatorii pot tokeniza datele și pot pregăti dataloader-e PyTorch care simulează mediul localizat al unui client real. Un pas crucial implică crearea unei clase personalizate de client care moștenește din „flwr.client.NumPyClient”.
Această clasă personalizată acționează ca o punte pentru schimbul de parametri. Ea include metode specifice pentru „get_parameters” și „set_parameters”, permițând serverului central să gestioneze eficient starea modelului pe toate nodurile participante. Odată ce bucla de antrenare locală este finalizată, clientul transmite ponderile actualizate către server. Acesta din urmă utilizează apoi o strategie – de regulă „FedAvg” (Federated Averaging) – pentru a agrega actualizările, creând astfel un model global mai inteligent și îmbunătățit fără a „vedea” vreodată datele originale.
De ce este important
Implicațiile pentru comunitatea de dezvoltatori sunt substanțiale. Acest framework simplifică tranziția de la experimentarea locală la producția federată:
- Confidențialitate sporită: Datele nu părăsesc niciodată mediul local al clientului, respectând cerințele de reglementare stricte și legile privind suveranitatea datelor.
- Reducerea costurilor de infrastructură: Prin distribuirea sarcinii de calcul pe mai multe dispozitive edge, presiunea asupra centrelor de date centralizate este semnificativ diminuată.
- Design agnostic față de framework: Deși exemplele principale utilizează PyTorch, arhitectura de bază Flower este compatibilă cu TensorFlow, oferind flexibilitate pentru diverse stack-uri tehnologice.
- Ușurința simulării: Flower include instrumente de simulare integrate care permit dezvoltatorilor să testeze configurările federate într-un singur mediu, cum ar fi Google Colab, înainte de a le implementa pe o infrastructură distribuită reală.
Perspective și implementări viitoare
Pe măsură ce adoptarea AI continuă să crească, tensiunea dintre performanța modelului și confidențialitatea datelor se va intensifica. Integrarea Hugging Face cu Flower oferă o cale clară pentru cercetătorii care au nevoie de capabilitățile avansate ale modelelor Transformer, dar sunt limitați de mandatele de confidențialitate. Deși exemplul actual se concentrează pe o sarcină de clasificare binară a sentimentelor folosind DistilBERT, modelul este extrem de extensibil. Pe măsură ce comunitatea continuă să rafineze aceste instrumente, ne putem aștepta la un suport mai larg pentru modele fundamentale mai mari și mai complexe, transformând practic orice dispozitiv conectat la internet într-un contribuitor potențial la o rețea de inteligență colectivă și privată.