Progrese în procesarea limbajului natural pentru turcă
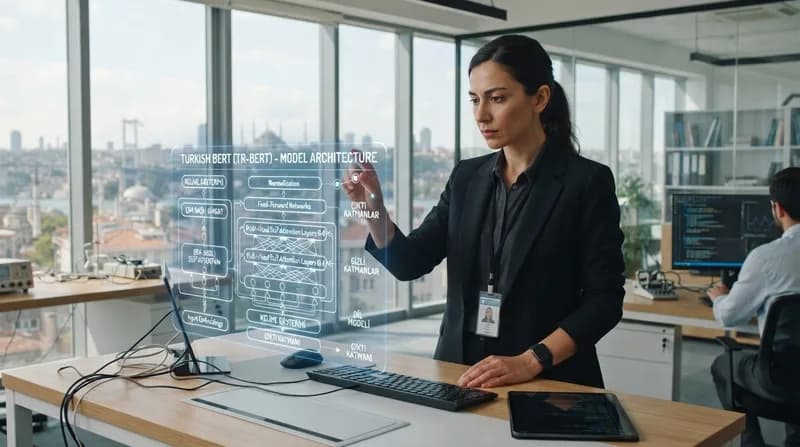
Într-o extindere semnificativă a capabilităților sale multilingve, Hugging Face a actualizat recent modelul dbmdz/bert-base-turkish-128k-cased. Această arhitectură transformer specializată este concepută pentru a gestiona complexitatea limbii turce cu o precizie sporită. Utilizând un vocabular de 128.000 de unități, modelul oferă o înțelegere nuanțată a structurilor gramaticale, aspect esențial pentru dezvoltatorii care lucrează la proiecte avansate de analiză a sentimentelor, traducere automată și sumarizare automată a textelor.
De ce este important
Modelele de machine learning antrenate pe limba engleză întâmpină adesea dificultăți cu limbile aglutinante, precum turca, unde cuvintele sunt formate prin adăugarea succesivă a diverselor sufixe. Acest model abordează aceste obstacole structurale, oferind o bază mai solidă pentru instrumentele AI care necesită o analiză lingvistică aprofundată. Pe măsură ce dezvoltarea AI la nivel global tinde către o accesibilitate mai largă, modelele optimizate pentru vorbitorii de alte limbi decât engleza rămân o componentă critică a infrastructurii tehnologice.
Specificații tehnice
- Arhitectură de bază: BERT (Bidirectional Encoder Representations from Transformers)
- Dimensiune vocabular: 128.000 de tokenuri
- Sensibilitate la majuscule: Cased (diferențiază majusculele de minuscule)
- Număr de parametri: 0,2 miliarde
- Data actualizării: 28 octombrie 2024
Lansarea reflectă tendința tot mai pronunțată din comunitatea de machine learning de a depăși modelele generice care încearcă să rezolve toate problemele prin aceeași metodă. Prin crearea unor modele mai mici și înalt specializate, cercetătorii pot obține performanțe ridicate cu un consum de resurse computaționale semnificativ mai mic decât în cazul modelelor de mari dimensiuni. Acest lucru face ca instrumentul să fie deosebit de valoros pentru startup-uri și instituții academice care au nevoie de capabilități puternice de procesare a limbajului natural, fără costurile energetice și financiare asociate antrenării de la zero a unor LLM-uri proprietare. Prin actualizarea sa, modelul este acum mai bine pregătit să susțină fluxurile moderne de date, oferind o integrare mai facilă pentru dezvoltatorii care creează agenți AI sau platforme software localizate. Fie că este utilizat pentru monitorizarea sentimentelor pe rețelele sociale sau pentru clasificarea documentelor, această iterație BERT reprezintă un punct de referință pentru excelența în procesarea limbajului natural (NLP) la nivel local.