Inteligenta ArtificialaAnaliza tehnica

Depășirea blocajelor: cum rezolvă Contrastive Search problema repetiției în generarea de text prin AI

Publicat
RRedactia ElectricBuzz
Depășirea blocajelor: cum rezolvă Contrastive Search problema repetiției în generarea de text prin AI
3 min de citit540 cuvinteRedactia ElectricBuzz

Pe scurt

“Noua metodă de decodare, numită „Contrastive Search”, abordează problema persistentă a textelor generate de AI care sunt repetitive sau incoerente, oferind o alternativă robustă la tehnicile tradiționale.”

Problemele decodării tradiționale

Procesarea Limbajului Natural (NLP) se confruntă de mult timp cu „degenerarea” textului generat. Timp de ani de zile, industria s-a bazat pe două metode principale: abordările deterministe, precum greedy search și beam search, și metodele stochastice, cum ar fi eșantionarea top-k sau nucleus (top-p). Deși aceste tehnici reprezintă pilonii modelelor lingvistice mari (LLM) moderne, ele eșuează frecvent atunci când trebuie să producă conținut lung, coerent și fluent.

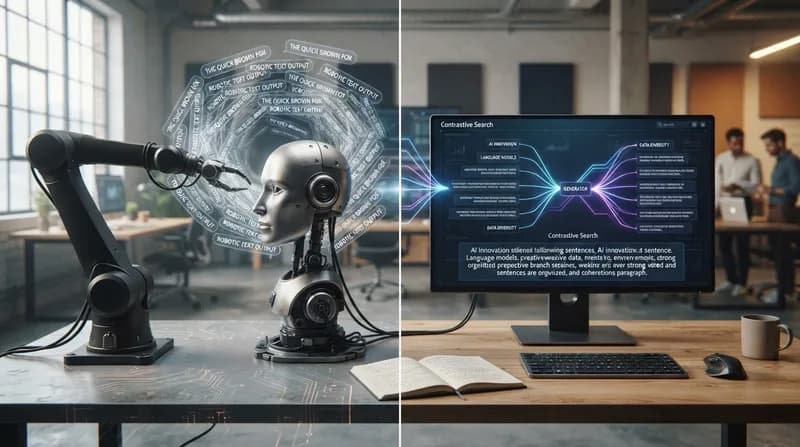
Metodele deterministe, care prioritizează selectarea celui mai probabil token la fiecare pas, blochează adesea modelul în bucle repetitive, unde fraze sau propoziții întregi sunt reciclate la nesfârșit. Pe de altă parte, deși metodele stochastice introduc un grad de aleatoriu pentru a sparge aceste bucle, ele sacrifică adesea coerența semantică, ducând la halucinații sau schimbări bruște de subiect care distrug fluiditatea narațiunii. Găsirea unui echilibru a fost, istoric vorbind, un proces anevoios de încercări și erori cu hiperparametri precum temperatura.

Introducerea metodei Contrastive Search

Contrastive Search, introdusă în biblioteca Hugging Face Transformers, oferă o soluție sofisticată pentru aceste limitări. În loc să se bazeze exclusiv pe probabilitatea atribuită de model, Contrastive Search evaluează tokenii candidați pe baza a două criterii distincte: încrederea modelului și „penalizarea pentru degenerare”. Acest obiectiv dublu asigură faptul că modelul rămâne concentrat pe text relevant și cu probabilitate ridicată, prevenind în același timp alunecarea în tipare repetitive.

Penalizarea este calculată prin utilizarea similarității cosinus în spațiul de reprezentare dintre un token candidat și contextul precedent. Dacă reprezentarea unui token candidat este prea similară cu contextul existent, penalizarea crește, descurajând efectiv modelul să aleagă acel token. Prin ajustarea hiperparametrului alpha, dezvoltatorii pot echilibra nevoia de continuitate logică cu dorința pentru un output creativ și non-repetitiv. Acest lucru permite generarea unor documente lungi și fluide, care rămân consecvente din punct de vedere semantic cu solicitarea inițială.

De ce este important

  • Elimină repetiția: Prin penalizarea activă a candidaților similari cu conținutul anterior, modelul evită capcana frecventă a repetării interminabile a unor fraze.
  • Menține coerența: Spre deosebire de eșantionarea aleatorie, care poate pierde firul narativ, Contrastive Search păstrează traseul logic stabilit de prompt.
  • Independență față de framework: Disponibilă atât pentru PyTorch, cât și pentru TensorFlow, metoda este acum complet integrată în ecosistemul Hugging Face Transformers pentru o adoptare simplă.
  • Generare superioară a textelor lungi: Permite crearea de documente complexe și de înaltă calitate, care sunt corecte gramatical și fundamentate factual pe contextul furnizat.

Implementare și perspective

Contrastive Search a fost concepută pentru a fi accesibilă, necesitând doar o actualizare la cele mai recente versiuni ale bibliotecii Transformers. Dezvoltatorii pot utiliza acum parametrii „penalty_alpha” și „top_k” în timpul fazei de inferență, beneficiind de un control fin asupra calității rezultatelor. Deoarece metoda nu necesită reantrenarea modelelor existente, aceasta poate fi aplicată imediat unor arhitecturi standard, cum ar fi GPT-2, pentru a obține performanțe vizibil mai apropiate de cele umane.

Privind spre viitor, trecerea către decodarea contrastivă reprezintă un pas către un control mai nuanțat asupra modului în care AI exprimă informația. Concentrându-se pe interacțiunea dintre distribuția de probabilitate a unui model și spațiul de reprezentare al textului, cercetătorii sunt tot mai aproape de crearea unor sisteme capabile de raționamente susținute și scriere creativă de înaltă calitate, care nu doar că sună uman, dar redau fluxul și structura unui text scris de o persoană.
SPONSORED
The 5 Best Over-Ear ANC Headphones of 2026, Tested & Ranked
Ghid Cumpărături Recomandat
92/100
Tech si Gadgeturi•12 min de citit

The 5 Best Over-Ear ANC Headphones of 2026, Tested & Ranked

We locked five over-ear ANC picks for 2026 — Sony WH-1000XM6, Bose QuietComfort Ultra 2, Soundcore Space One, Sennheiser Momentum 5, and Apple AirPods Max 2 — then stress-tested them on lab metrics, long-term owner truth, and live street prices.

Articole similare

Articole asemanatoare, ordonate semantic dupa subiect si actualitate.

Leadership în machine learning: experții din industrie își împărtășesc viziunea
Inteligenta Artificiala

Leadership în machine learning: experții din industrie își împărtășesc viziunea

O analiză a perspectivelor liderilor de top din domeniul machine learning despre modul în care AI transformă e-commerce-ul, ingineria și alte sectoare cheie.

Punți între teorie și practică: Hugging Face introduce demo-uri interactive de AI pe arXiv
Inteligenta Artificiala

Punți între teorie și practică: Hugging Face introduce demo-uri interactive de AI pe arXiv

O nouă colaborare între Hugging Face și arXiv aduce demo-uri de machine learning interactive, direct în browser, pe paginile lucrărilor de cercetare, facilitând interacțiunea cu cele mai noi descoperiri științifice.

AI axat pe confidențialitate: analiza sentimentelor, posibilă pe date criptate
Inteligenta Artificiala

AI axat pe confidențialitate: analiza sentimentelor, posibilă pe date criptate

O inovație în tehnologia de protejare a confidențialității permite modelelor AI să proceseze și să analizeze sentimentele fără a decripta vreodată datele utilizatorilor.

Hugging Face extinde infrastructura pentru o procesare AI fluidă
Inteligenta Artificiala

Hugging Face extinde infrastructura pentru o procesare AI fluidă

Hugging Face rafinează ecosistemul de inferență, punând accent pe implementări performante pentru modelele de tip transformer, cu scopul de a facilita adoptarea soluțiilor AI.

Hugging Face îmbunătățește capabilitățile vision-language prin Idefics2-8B
Inteligenta Artificiala

Hugging Face îmbunătățește capabilitățile vision-language prin Idefics2-8B

Hugging Face a lansat o versiune actualizată a modelului Idefics2-8B, stabilind un nou standard pentru procesarea open-access de tip imagine-către-text.

În interiorul Anthropic: cum remodelează AI dinamica forței de muncă și cererea de competențe
Inteligenta Artificiala

În interiorul Anthropic: cum remodelează AI dinamica forței de muncă și cererea de competențe

Un raport intern al Anthropic scoate la iveală modul în care fluxurile de lucru bazate pe AI schimbă tendințele de angajare, indicatorii de productivitate și interacțiunea dintre oameni și tehnologie în cadrul companiei.

Meta retrage o clauză controversată privind colectarea datelor de pe web, în urma criticilor
Inteligenta Artificiala

Meta retrage o clauză controversată privind colectarea datelor de pe web, în urma criticilor

Meta a eliminat din termenii și condițiile comerciale formulările ambigue care au stârnit temeri privind intenția companiei de a accesa site-urile companiilor pentru antrenarea modelelor AI.

Hugging Face lansează un curs complet și un simpozion live despre modelele de difuzie
Inteligenta Artificiala

Hugging Face lansează un curs complet și un simpozion live despre modelele de difuzie

Hugging Face își propune să demistifice modelele de difuzie printr-un curs educațional gratuit și un eveniment comunitar live cu experți de renume.